ITL-424723421eb2
观看视频
核心要点
- 引文必须支持具体的临床主张。 文章是否存在、是否相关、摘要是否科学准确,以及翻译是否忠实,是四个不同的检查环节。[1]
- 文献真实存在,只是起点。 另一项 2026 年研究检查了 4,979 条引文,未确认存在虚构文献,但并未评价这些文献是否支持相应的临床回答。[2]
- 一致性不等于准确性。 在麻醉学研究中,合并两种评级后的 AI–人工一致率为 85.8%;要求三种评级完全一致时,一致率为 47.5%。[1]
- AI 判为 PASS,并不意味着无需再看原文。 较宽泛的预警规则留下了 296 条未标记引文,其中 28 条被人工判为 FAIL;人工评级是比较参照,并非已确立的真值。[1]
- 优先核对会改变临床含义的细节。 人群、剂量、结局、不等号,以及翻译后的临床术语,都值得与原文直接对照。[1]
医生准备教学幻灯片或临床摘要时,可能收到一个看似合理的答案,附有真实 DOI,还有另一个 AI 系统给出的肯定评价。真正需要决定的是:能否采用这条临床主张。下一步最有用的动作,是打开原文,找到实际支持它的段落。
Li 等发表于 2026 年的研究,为这样做提供了具体理由。研究检查了麻醉学知识库中与临床问题、中英文摘要相连的引文。其核心价值在于帮助医生在使用证据前进行核查;研究并未验证临床决策或患者结局是否改善。[1]
从“找到文章”走到“核实主张”
研究者从 19 个亚专科抽取了 570 条引文记录,每条均接受一次 AI 评价和一名指定人工评审者的评价。四个领域分别是:文章是否存在、与所分配问题是否相关、摘要是否科学准确,以及中英文之间是否保留相同的临床含义。[1]
这四个领域对应不同的实际动作。题目与 DOI 匹配,确定的是文章身份;方法部分说明研究涉及什么患者和干预;结果部分说明实际观察到了什么;讨论部分则可能提出研究并未直接检验的解释。一个摘要可以完整保留书目信息,却改变其中某一层关系。
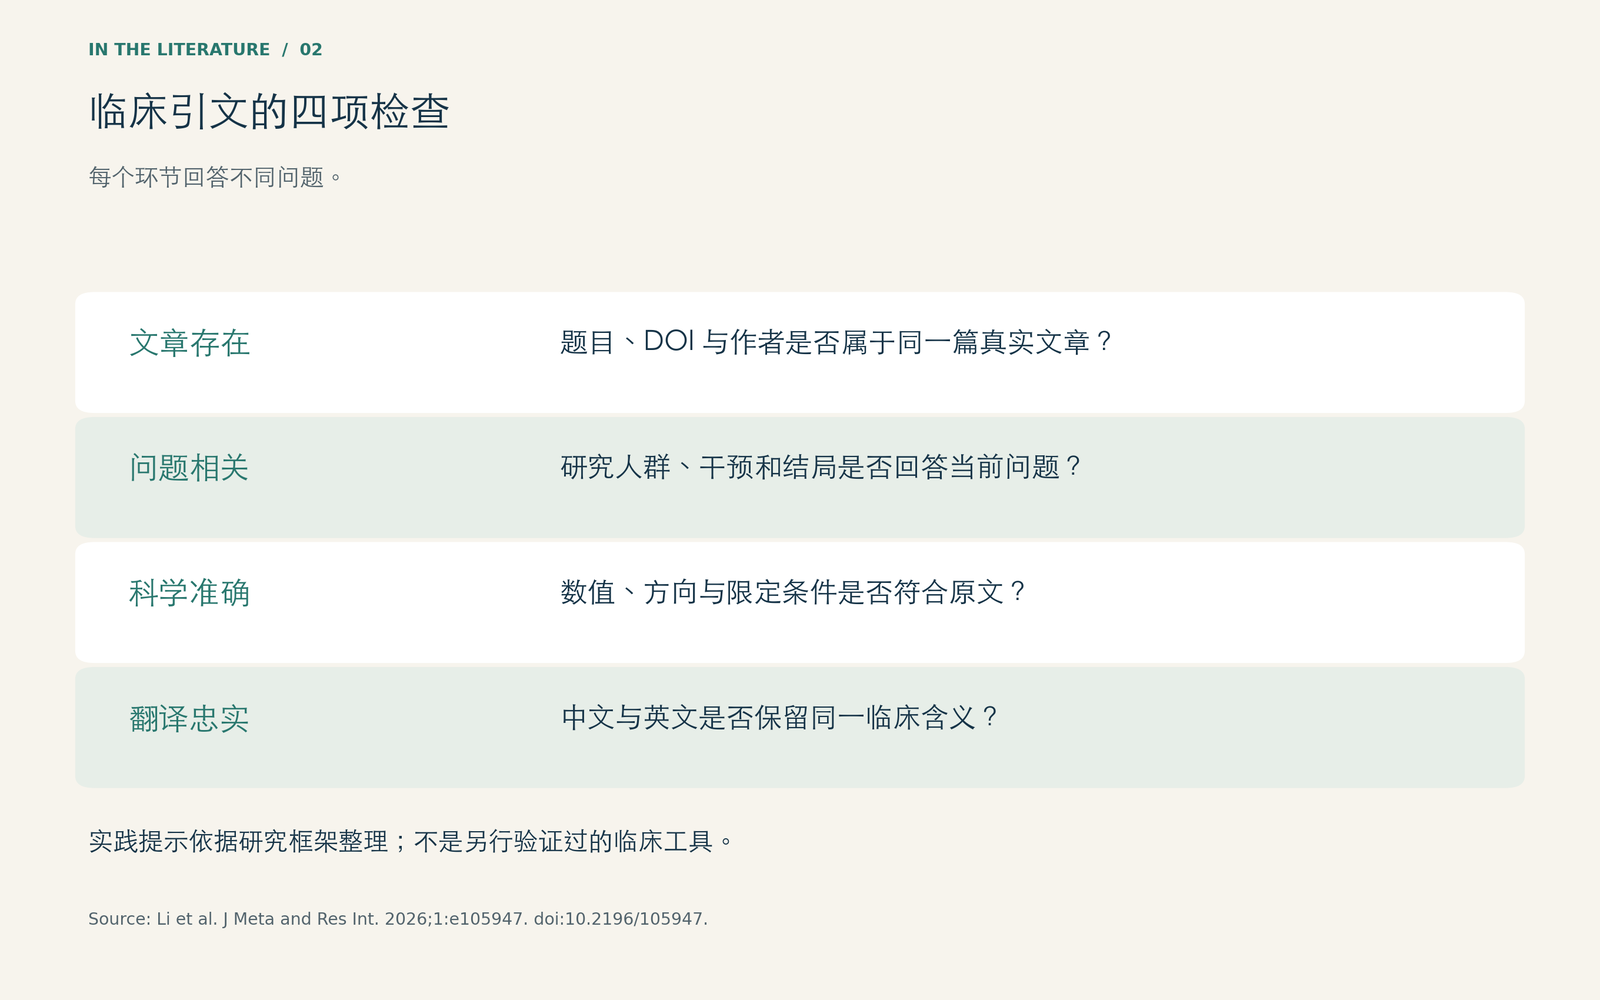
图 1. 四项检查分别回答不同的问题。检查领域来自研究;具体提示是对这一框架的临床应用。 [1]
Lotan 等发表于 2026 年的研究,有助于理解这个区别。该研究分析了五个专科、150 个提示词所产生的 4,979 条引文,没有确认虚构文献,但发现三条会议摘要存在作者归属错误。不过,作者明确没有评价所引材料是否支持临床主张。因此,书目核验与主张核验回答的是不同问题;前者结果良好,不能填补后者尚未评价的部分。[2]
看一致率时,先看评级如何定义
麻醉学研究使用 PASS、CONDITIONAL 和 FAIL 三种总体评级。主要的事后二分类分析将 PASS 与 CONDITIONAL 合并。因此,即使 AI 判为 PASS、人工判为 CONDITIONAL,二分类分析仍将它们计为一致,但二者对是否需要保留条件的判断其实不同。[1]
按照这一二分类定义,一致率为 489/570,即 85.8%;要求三种评级完全相同时,一致率为 271/570,即 47.5%。差异来自对同一组配对评价提出了不同问题。这两个比例都不能说明有多少引文被独立证实为正确。[1]
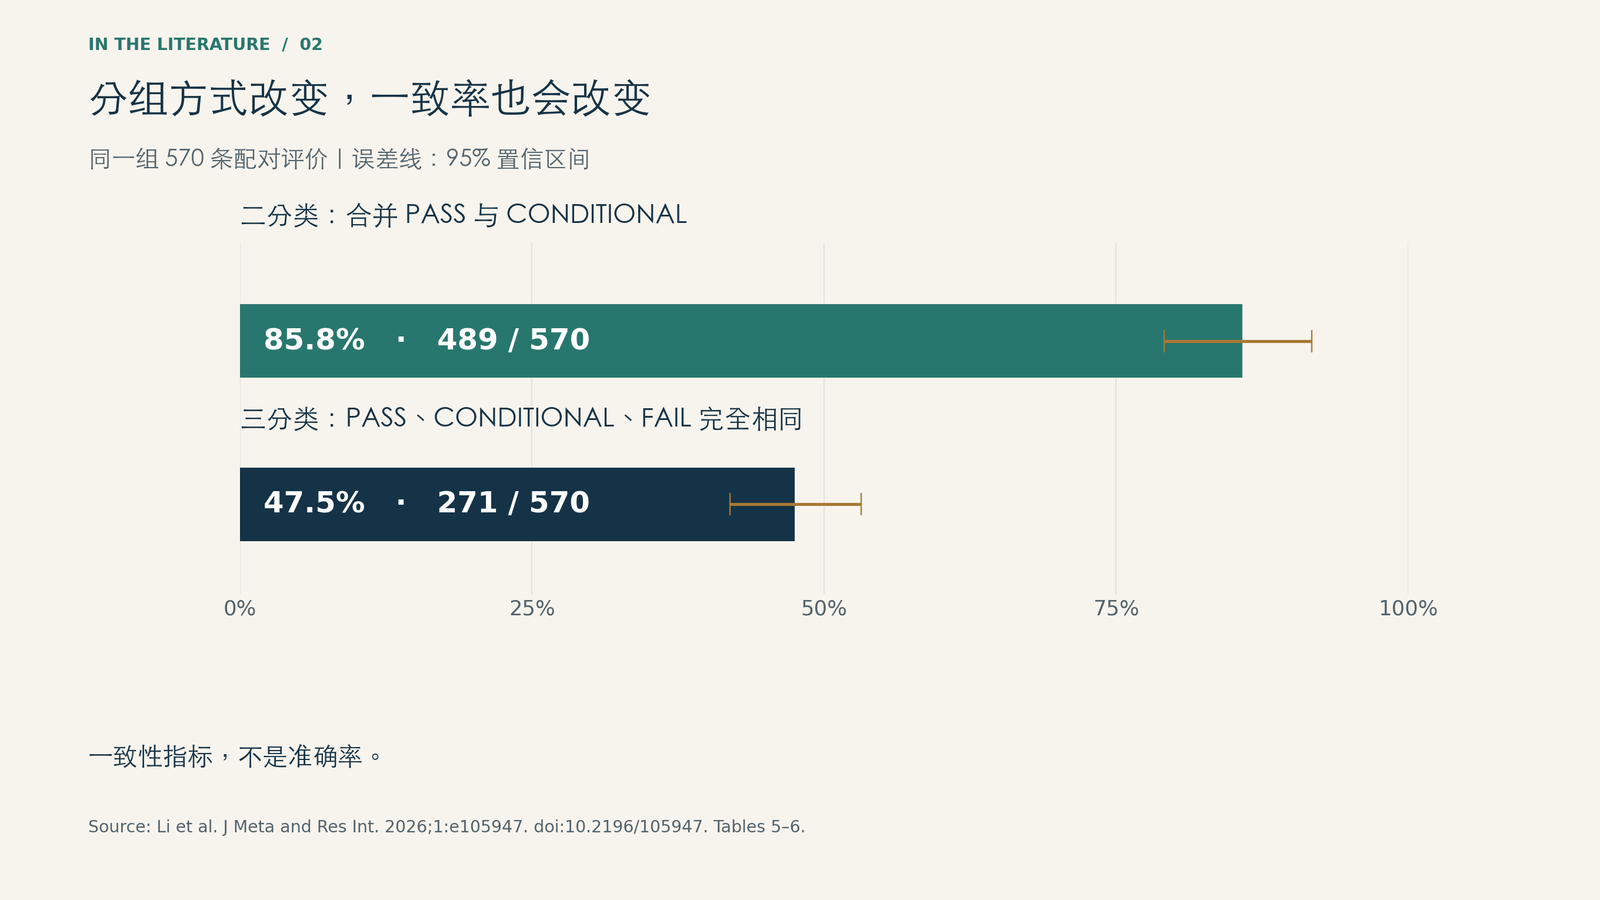
图 2. 评级分组方式改变,同一组数据得到的一致率也会改变。误差线为原文报告的 95% 置信区间:二分类为 79.12–91.75%,三分类为 41.93–53.16%。 [1]
研究报告的机会校正系数也明显不同:二分类 Cohen κ 为 0.0645,Gwet AC1 为 0.8334。二者采用不同的机会一致性计算方法,对不均衡的类别使用情况有不同反应。只挑看起来更令人放心的系数,会遮蔽原始评级所反映的问题。对实际使用这些内容的医生而言,更有用的是弄清分歧究竟在哪里,以及原文能否解决它。[1]
每条引文只有一名人工评审者,且评审者与亚专科绑定,部分评价未设盲。因此,人工 FAIL 是进一步检查记录的理由,并非独立金标准下对 AI 错误的确认。用本研究描述某个 AI 工具的可靠性时,必须保留这一含义。[1]
用预警安排工作,也看它遗漏了什么
较宽泛的预警规则同时标记 AI 的 CONDITIONAL 和 FAIL。它从 570 条引文中选出 274 条,覆盖了 74 条人工 FAIL 中的 46 条。在其余 296 条未标记引文中,仍有 28 条被人工判为 FAIL。反过来看,274 条被标记引文中,只有 46 条属于人工 FAIL:被标记也不意味着错误已经得到确认。[1]
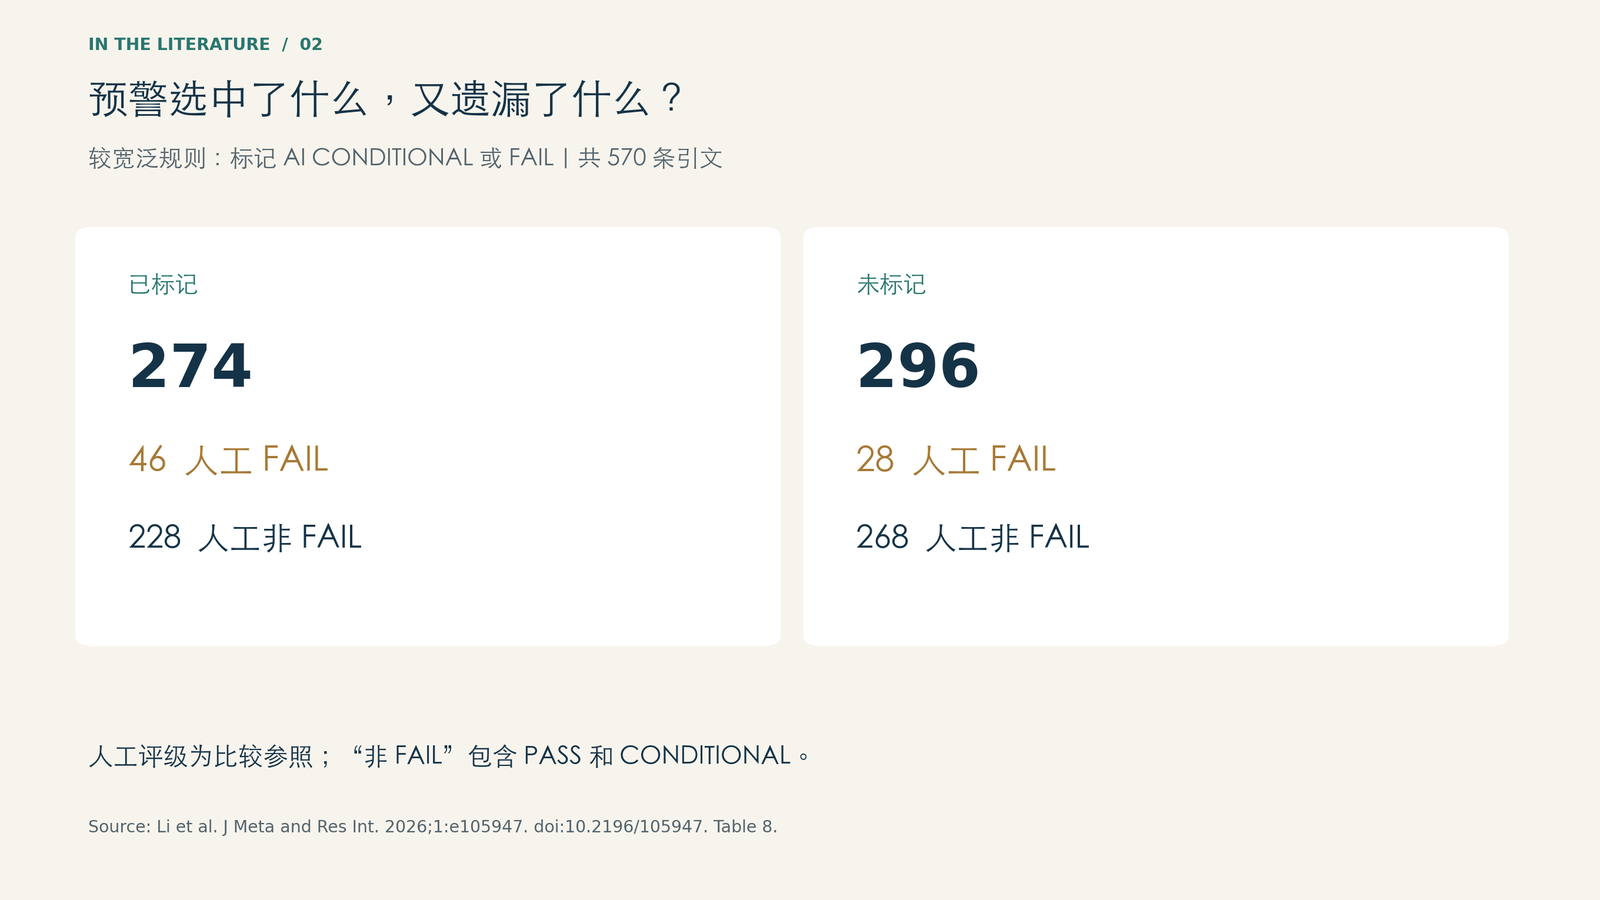
图 3. 较宽泛的预警规则选中了哪些记录,又留下了哪些。人工非 FAIL 包括 PASS 和 CONDITIONAL。这是评价结果的交叉分类,不是已确认错误的计数。 [1]
若只标记 AI FAIL,待查清单会更短,但只能覆盖 74 条人工 FAIL 中的 5 条。研究没有测量复核耗时,也未确定哪种策略效率最高。一种合理的实践方式,是用预警安排优先检查顺序,同时继续核查未被标记但会影响临床判断的主张。自动生成的标签本身,不能完成最后这一步判断。[1]
最后一步,要落到具体临床含义
研究保留的实例说明,笼统的“引文已验证”并不充分。有篇文献讨论腹横肌平面阻滞的安全性和中位剂量,而所分配的问题是最大剂量;另一个摘要颠倒了 TAPSE 阈值的临床意义;还有中文摘要将 “stroke volume” 译成了与脑卒中有关的词,而非心脏术语“每搏量”。这些实例展示可能出现的问题,不能据此估计其发生频率。[1]
在把一条主张带入教学或实践前,先明确自己究竟要使用哪一句话,再对照原文中的人群、干预、对照、结局、时间点及限定条件。涉及数值时,核对分母、单位、效应方向和不等号;涉及双语内容时,核对临床含义,而不仅是语言是否流畅。这是对研究检查领域的实践应用,并非另行验证过的临床检查表。[1]
重复让 AI 核查,也需要谨慎解释。在后来对 112 条记录的再次评价中,二分类评级比三分类精确评级更容易重复,一些原先的 FAIL 发生了变化。检索条件并未固定,实际后台模型也未获得独立确认。因此,再次得到一个令人放心的回答,仍不能替代对最初原文疑点的解决。[1]
临床带走的三点
- 核实主张与原文之间的关系。 真实文章和正确 DOI,不能证明它回答了当前问题,或支持附在旁边的那句话。
- 用 AI 预警引导注意力。 未被标记但具有临床后果的主张,也要检查;遇到分歧时回到原文。
- 让证据在每次转述中保持原意。 从原文到摘要、幻灯片或文章,数字、限定语和翻译术语都应忠实保留。
作者说明:Juan Li 是本文讨论的麻醉学引文核查研究的第一作者。
参考文献
- Li J, Huang S, Qiu Y, Chen W, Zhang Y, Zhao X, et al. Human-AI agreement in citation validation of an AI-generated subspecialty anesthesiology knowledge base: cross-sectional paired validation study. J Meta and Res Int. 2026;1:e105947. doi:10.2196/105947.
- Lotan T, Omar M, Barash Y, Kruskal JB, Ahmed M, Brook OR, et al. Reference quality of OpenEvidence across five medical specialties. npj Health Syst. 2026;3:87. doi:10.1038/s44401-026-00142-8.