一位麻醉医生如何让产科、麻醉与复苏的实践可以相互比较——以及这个评分的边界在哪里。
中文阅读 · 英文原文:1953: Virginia Apgar Gives the Newborn a Common Language
观看配套影片
1953: Virginia Apgar — The First Minute · 在 YouTube 观看
(视频托管在 YouTube,中国大陆可能无法访问。)
历史锚点:1953年。日期细节和来源的限定说明见下文。
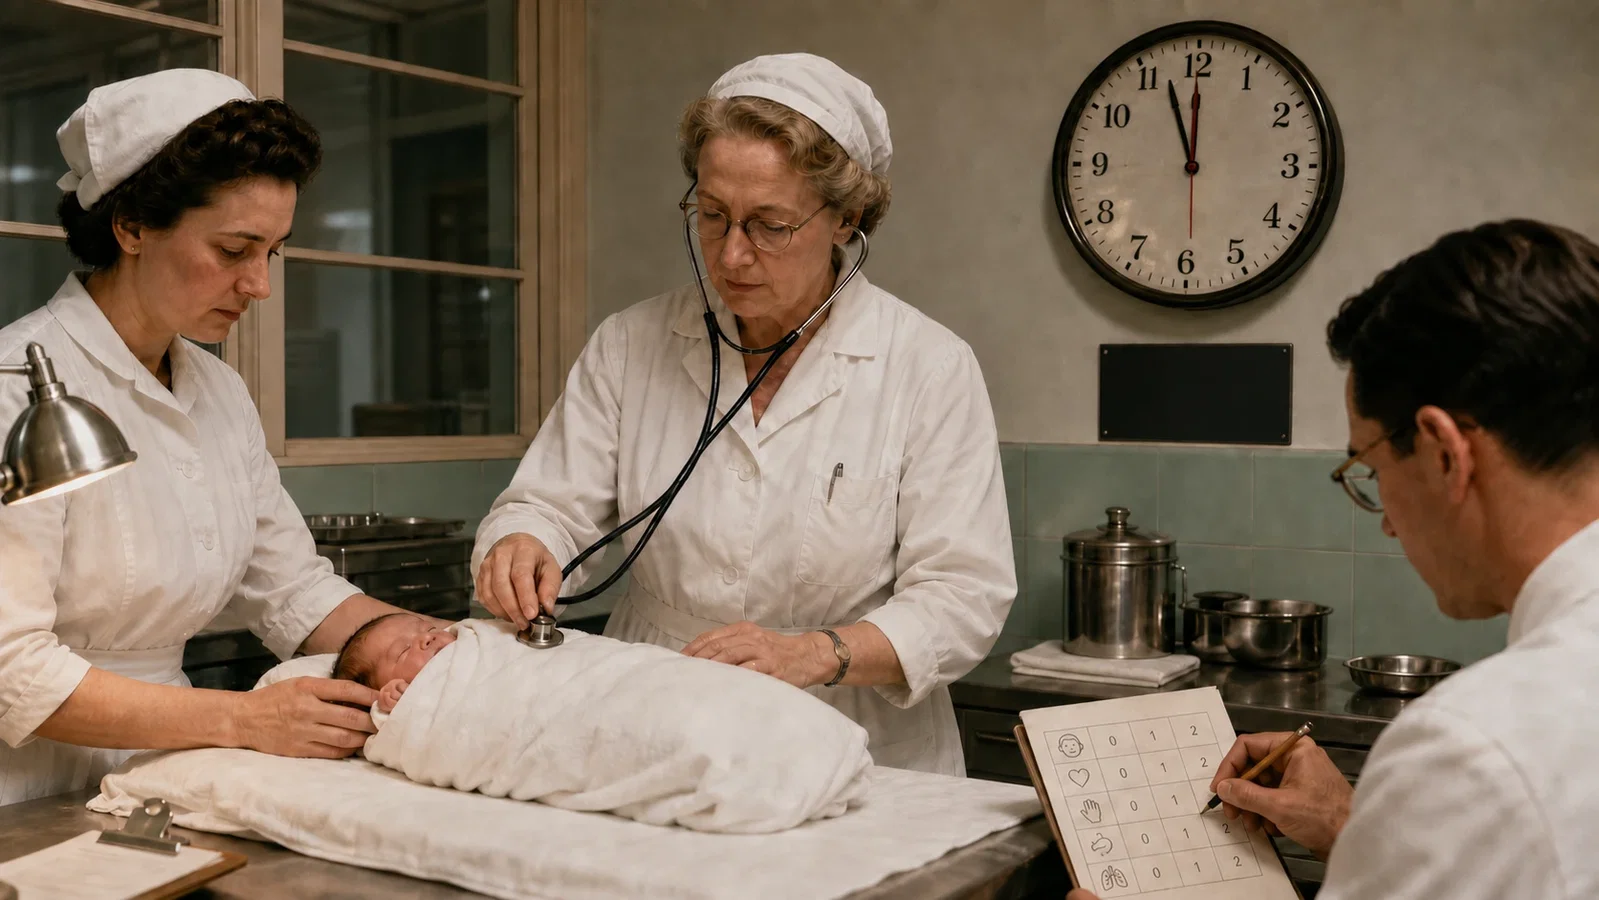
1952年的产房里并不缺观察者,缺的是一种描述所见的共同语言。那年9月,Virginia Apgar在弗吉尼亚海滩的一场麻醉学会议上报告了一种新生儿评价法,第二年正式发表。她的出发点并不是把婴儿简化成一个数字,而是认识到:人们熟悉的那些描述,无法可靠地相互比较。
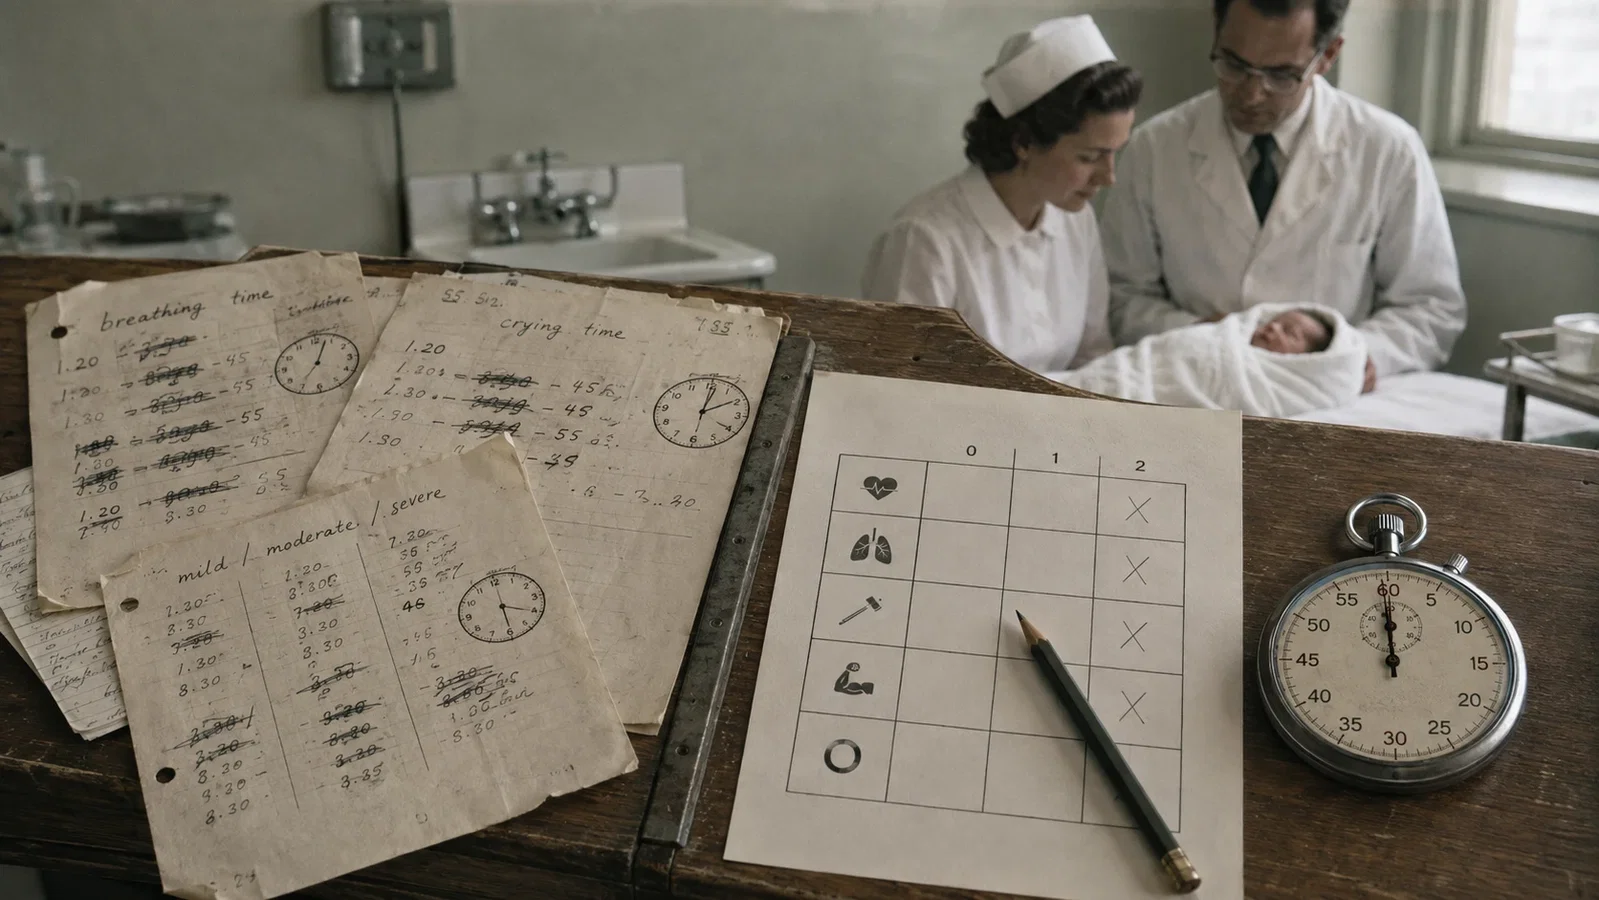
当时的记录用的是“开始呼吸时间”“开始啼哭时间”,或轻度、中度、重度抑制。每个说法背后都藏着问题。受产妇用药或全身麻醉影响的婴儿,可能先喘一口气,随后几分钟都处于呼吸暂停;有些婴儿始终没有发出观察者认为“满意”的哭声;轻、中、重的抑制分级又给个人解释留下很大空间。因此,不同产科做法、麻醉方法和复苏手段得到的结果,没有一个稳定的共同终点。
一、五项体征,固定在同一分钟
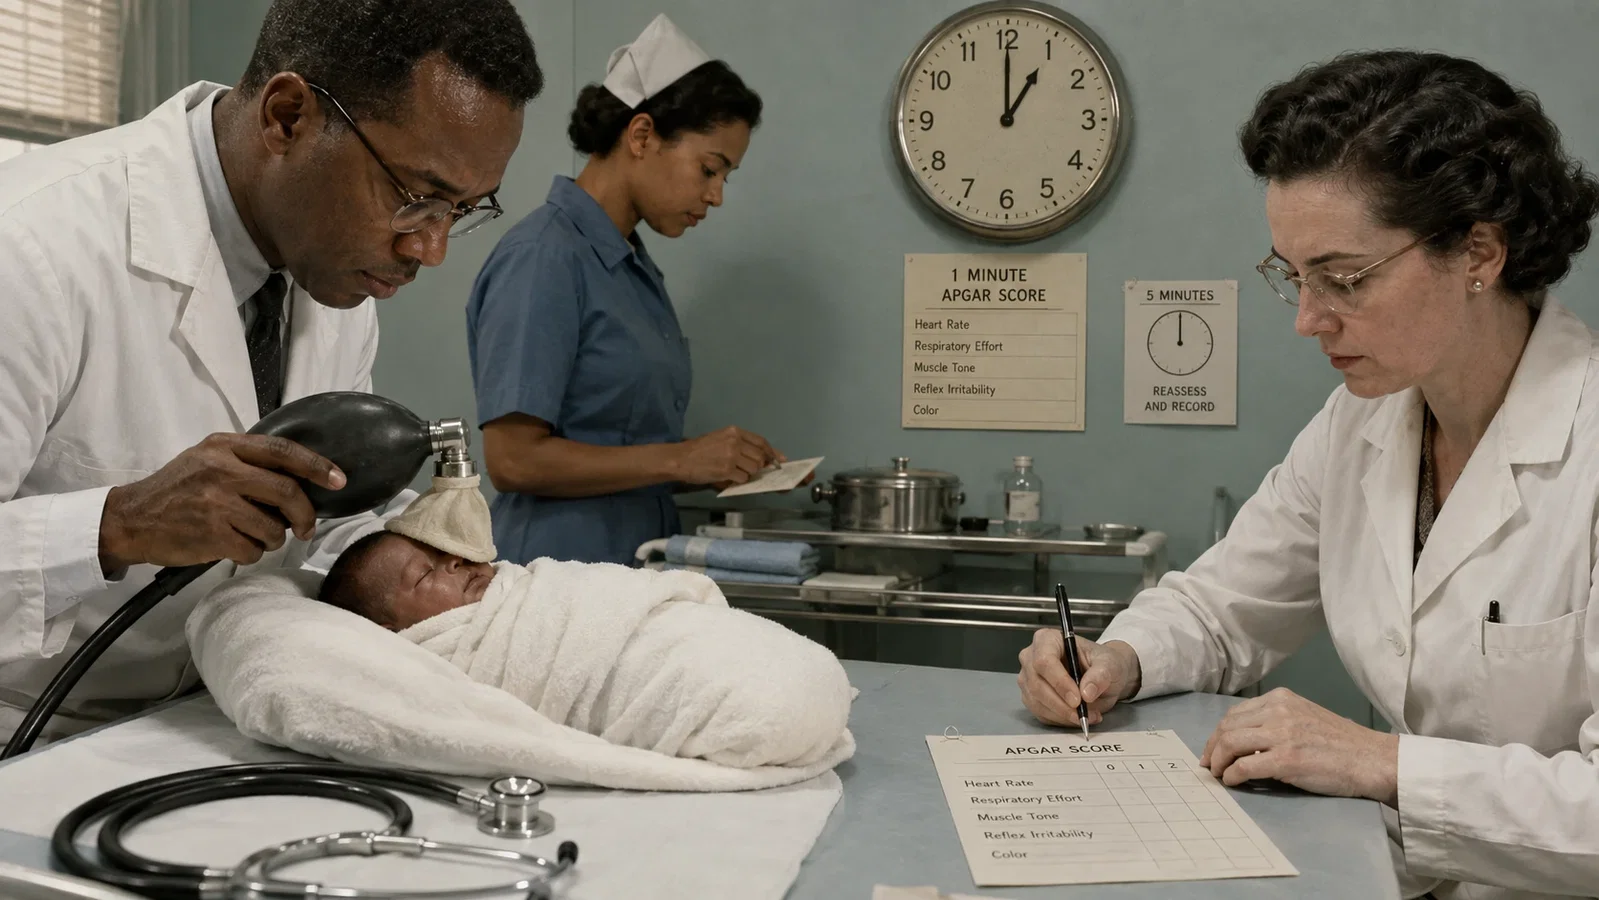
Apgar选出五项容易评估、又不妨碍照护的体征:心率、呼吸努力、反射兴奋性、肌张力和肤色。每项记0、1或2分,总分最高10分。评估时刻固定在婴儿完全娩出后的60秒。
固定的时刻和总分同样重要。在第一次喘气时做的判断,无法与持续啼哭之后或观察几分钟之后做的判断相比。把时间固定下来,评分就让临床医生有了一种共同的方式,来讨论产科干预、产妇镇痛与麻醉、复苏以及不同医院之间的差异。
1953年的论文里没有后来那套助记词Appearance, Pulse, Grimace, Activity,和Respiration。这种展开便于记忆,但不应倒推为Apgar当年的原始术语。她的论文直接描述五项临床体征,强调的是统一的方法和准确的观察时刻。
每一项体征也必须反映婴儿在那一刻的状态。心率可以通过观察心前区或触摸靠近腹部的脐带来判断;60秒时的呼吸努力,比此前偶尔的一次喘气更重要;反射反应、肌张力和肤色也在同一时刻记录。随着病例积累,许多评分由在场的麻醉住院医生给出。Apgar后来建议,评分者最好不是接生的人,因为接生者可能忙于照护,或对眼前的结果怀有情感投入。
二、最初的数字能说明什么
论文覆盖七个半月内的2,096次出生,但这个数字不是评分分析的分母。报告的各评分组共有1,021名婴儿:
- 0–2分的65名婴儿中,死亡9名,即14%。
- 3–7分的182名婴儿中,死亡2名,即1.1%。
- 8–10分的774名婴儿中,死亡1名,即0.13%。
这条梯度很醒目。在这组最初的医院病例中,分数越低,新生儿死亡的比例越高。评分把散乱的观察整理成可以讨论和比较的状态分组。
这一设计并没有检验使用评分是否降低了死亡率。既没有“评分”与“不评分”照护之间的随机比较,数据也来自单一中心的早期经验。能够成立的结论要窄得多:在最初被评分的1,021名婴儿中,较低的分数与较高的死亡率相关。这一发现支持描述和风险分层;它不能说明评分避免了多少死亡,也不能把后来婴儿死亡率的下降归功于这张表本身。
三、与箭毒时代的直接联系
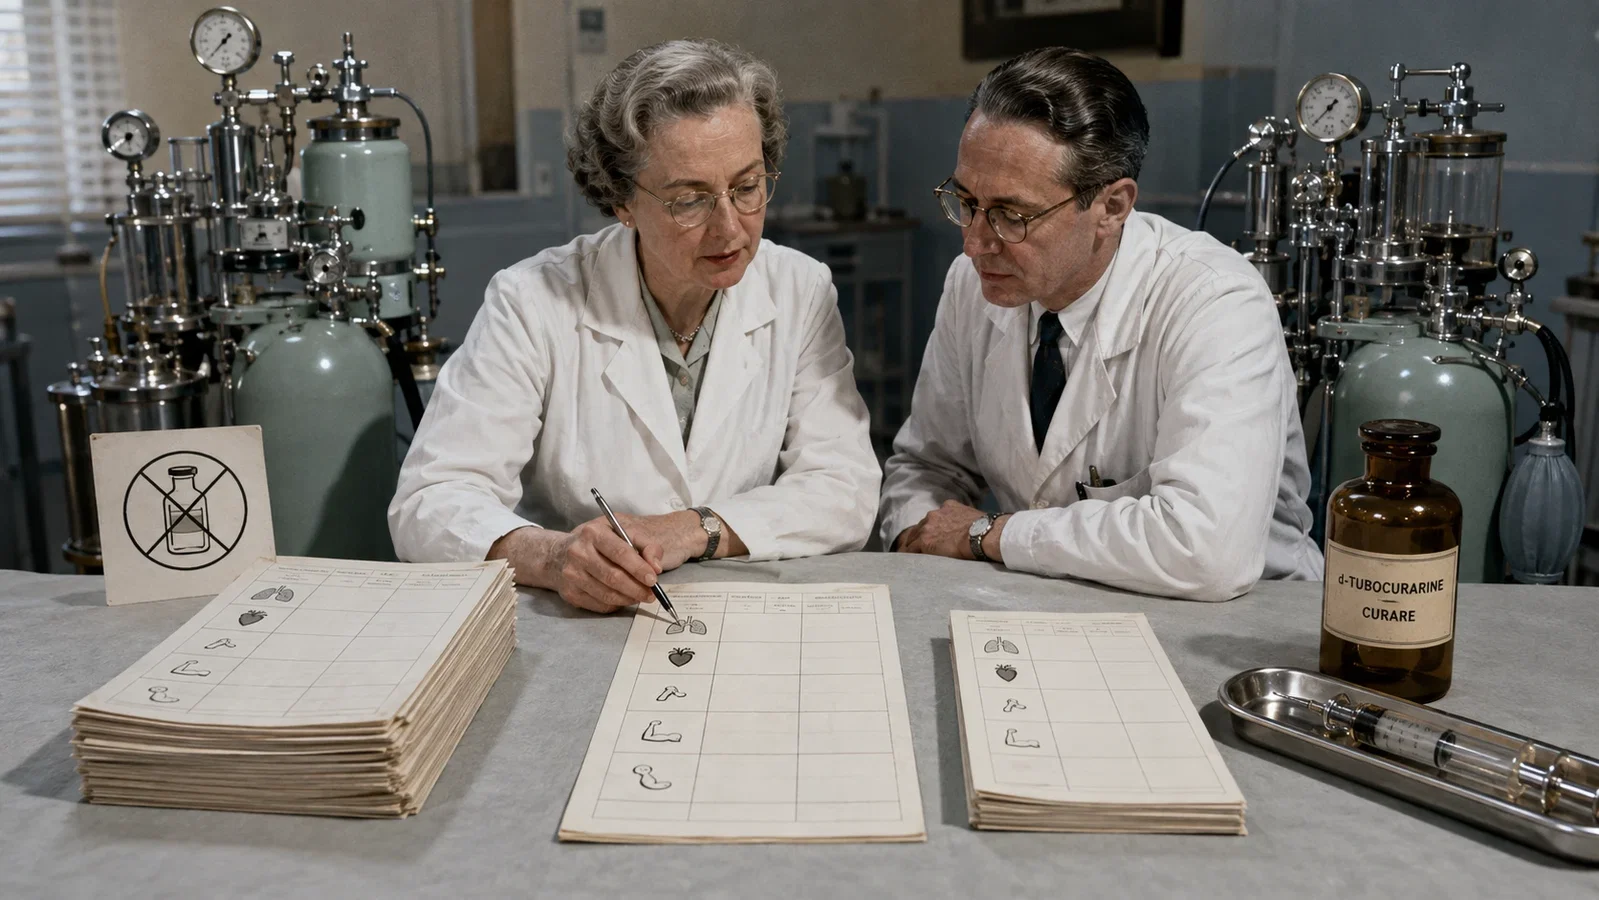
Harold Griffith与Enid Johnson把箭毒引入全身麻醉,才过去十余年。Apgar的论文已经在问:新生儿的状态如何随产妇麻醉方式而不同?这一联系不是后人回头编出来的,原始报告确实讨论了d-tubocurarine、flaxedil、succinylcholine和decamethonium。
有20名产妇在环丙烷麻醉中静脉使用了肌松药:17名用d-tubocurarine,另外三种药各一名。她们的婴儿只有13名得到评分。论文把41例环丙烷麻醉、未加肌松药的剖宫产与13例环丙烷加肌松药的剖宫产作比较。两组平均分都是5.0,每组约70%的婴儿接受了某种形式的给氧。
在这组病例中,Apgar没有发现加用肌松药能让婴儿状态更好的证据,并指出产妇呼吸抑制是这种做法的缺点。这些观察不是现代的药物试验:两组都很小,没有随机分组,几种肌松药合在一个类别里,产科风险、麻醉处理和当时的复苏做法都可能影响结果。这一比较既不能证明箭毒类药物不通过胎盘,也不能证明它们造成了伤害。
它的历史价值在于可比性。一个共同的新生儿评分,让麻醉医生能把产妇用药的选择和新生儿状态放进同一场讨论。Griffith一文展示了麻醉被拆分成可以分别控制的组分;Apgar一文则显示,伴随这些选择而来的影响,如何开始用一种共同的临床尺度来记录。
四、评分不是开始复苏的信号
一项标准,如果它的时机被误解,就可能变得危险。Apgar在1966年的回顾中纠正了一种做法:有些团队要等一分钟评分做完才开始积极复苏。她说这种做法是错误的。已知婴儿需要帮助时,应在确保气道通畅后尽快开始复苏;即使复苏已在进行,第一次评分仍在60秒时给出。
这一区分至今仍是正确使用评分的核心。Apgar评分描述婴儿在规定时刻的状态,也可以帮助记录对复苏的反应;它不决定是否需要初步复苏、应采取哪一步,或何时开始治疗。五分钟评分,以及一分钟到五分钟之间的变化,提供了更多群体层面的信息和关于反应的信息,但它们仍然不能预言某一个婴儿的死亡或未来的神经功能。
美国妇产科医师学会和美国儿科学会的现代指南把这条边界说得很清楚:单凭Apgar评分不能诊断窒息,也不应用来预测个体的死亡或神经结局。低分可以在群体中与风险增加相关,却仍然无法决定某一个婴儿的未来。大多数低分婴儿不会发展为脑性瘫痪。状态描述、群体关联和个体预测,是不同的主张。
五、最不稳定的一项,从一开始就在那里
Apgar称肤色是五项中最不令人满意的一项,也是观察者之间分歧最多的一项。即使其他体征得分很好,许多婴儿在一分钟时的肤色也拿不到满分。她也意识到,天然的皮肤色素可能干扰这项观察。一个把最好状态等同于“全身粉红”的标准,并不能在所有肤色上提供同样可靠的目测判断。
2025年的一篇系统综述纳入10项研究,考察对黑人、亚裔及其他少数族裔新生儿的Apgar评分或紫绀目测。综述发现评分做法可能存在差异,并证实紫绀难以靠肉眼评估。证据基础有限:7项Apgar研究中,只有两项在全部五个质量维度上被评为低偏倚风险;研究的定义和结局差异很大,除一项外都按种族或族裔对婴儿分类,而没有测量肤色。这种异质性使meta分析无法进行。
谨慎的结论不是“每一个Apgar评分都已被证明含有同一种系统性偏差”,而是:其中的主观成分,在不同肤色的新生儿身上未必同样可靠。脉搏血氧监测后来把氧合变成连续的数字估计,但它并不是天然无偏的替代物,也不能取代心率、呼吸、反射反应和肌张力所提供的临床信息。
六、共同语言,而不是命运数字
Apgar评分最持久的贡献,不是把新生儿压缩成0到10之间的一个数字,而是一种纪律:不同的观察者在同一分钟检查同样的五项体征,并用同一种表格记录。这种共同语言让产科、麻醉和复苏团队更容易沟通、比较做法、研究患者群体。
这种语言之所以仍然有用,是因为它的边界可以说清楚。评分可以描述、沟通、比较和分层;它不能让照护等待,不能单独诊断窒息,也不能把群体关联变成个体预后。它的肤色一项也表明,标准化并不能让每一项观察都变得客观。
这段历史引出一个相关的问题:当肉眼观察不稳定时,能否把生理变化转换成连续、可读的信号?二十年后,青柳卓雄将从耳式血氧计的“噪声”中找到脉搏血氧测量的原理。脉搏血氧测量并不是简单地取代了Apgar评分。它代表了同一种测量冲动的另一种形式:给临床团队一个共同的信号,同时保留这个信号能说明什么的限度。
来源与阅读范围
Apgar V. Curr Res Anesth Analg. 1953;32:260-267 (PMID 13083014); Apgar V. Pediatr Clin North Am. 1966;13:645-650; Hammer DJ, Portu R, Santiago A, Colon-Morales MA. Accurate Apgar Scoring. 1968 NLM scientific exhibit; ACOG/AAP Committee Opinion No. 644. Obstet Gynecol. 2015;126:e52-e55, reaffirmed 2025; Fair FJ et al. Pediatr Res. 2025;97:939-952 (PMID 39277651; PMCID PMC12055595).
视觉诠释
这些插图探索当时的情境和观念。画中的人物、动作、器械和文件都是重构,不能作为它们确切历史面貌的证据。
继续阅读
相关阅读只表示问题和背景相关,本身不证明历史上的影响关系。
- 1847年:Simpson把产痛与宫缩分开观察
- 1974年:青柳卓男让缺氧变得可见
- 1987年:NRP打造一门可以传递的新生儿复苏课程
- 2001年:COMET 评估分娩镇痛对母亲与新生儿的影响
- 1945–2009年:小儿有囊气管导管——重新思考尺寸、位置与证据
- 2016–2019年:GAS、PANDA与MASK缩小了小儿麻醉神经毒性的疑问
- 2024年:ASA 把 PACU 交接改为“留在患者身边”
Anesthesia Epochs · The Source Room · About & Editorial Method
中文版与英文原文一一对应;如有出入,以英文版为准。来源与阅读范围见上文。插图均标明为原始资料图片或 AI 制作。历史叙述仅供教育,不是当前的治疗建议。