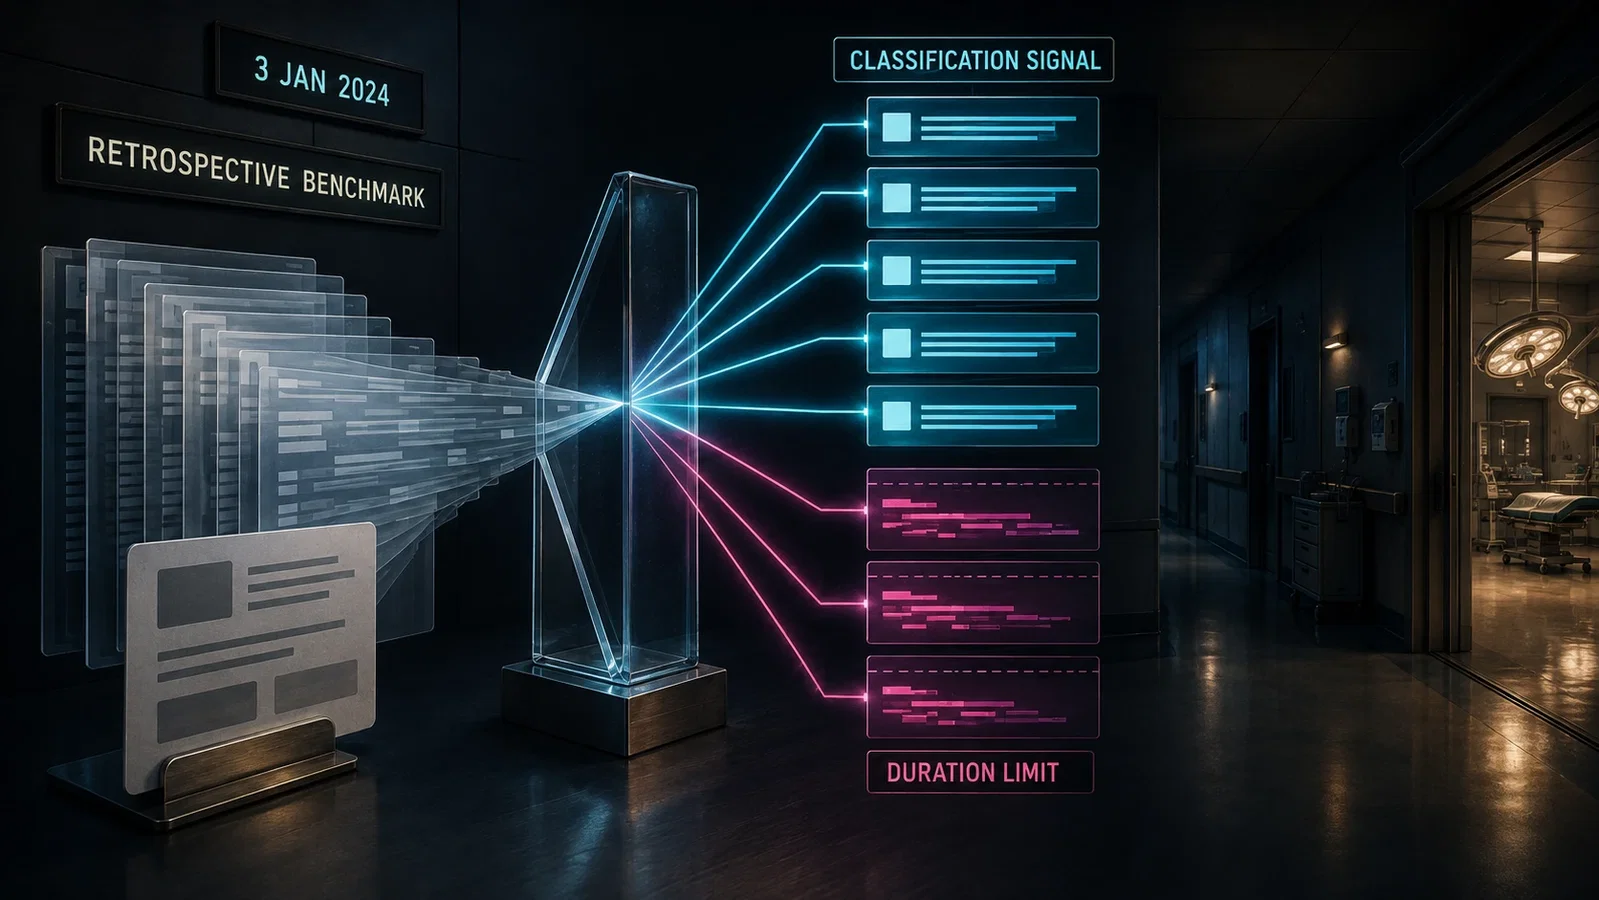
2024年1月3日,八项围术期任务公开:平衡后的回顾性样本显示出分类信号,而不是在真实患病率下的床旁验证。
中文阅读 · 英文原文:2024: GPT-4 Turbo Classifies Preoperative Text but Struggles to Predict Duration
观看配套影片
2024: GPT-4 Turbo Reads Preoperative Notes · 在 YouTube 观看
(视频托管在 YouTube,中国大陆可能无法访问。)
历史定位:2024年。日期细节与来源限定见正文。
在任何人证明它在临床上有用之前,这个回答听起来就已经很像临床判断了。
这正是大语言模型特有的力量。传统风险模型给出一个数字,并引人追问它的区分度、校准度和验证情况。语言模型既能给出这个数字,又能用流畅的文字把它与病历联系起来,让同样的追问显得不那么紧迫。
2024年1月3日,Philip Chung 等人公开了一项研究,把这个问题直接放进了围术期医学。GPT-4 Turbo 读取手术预约信息与选定的临床记录,然后回答麻醉医师熟悉的八个问题:ASA 身体状况分级、术后住院、ICU 入院、非计划住院、院内死亡,以及 PACU、住院和 ICU 的停留时长。
五个月后,同行评议版本发表于《JAMA Surgery》。核心分数保留了下来。变化最大的,是围绕这些分数划定的边界。
这不是“AI 麻醉医师”的到来。它是一个严肃的围术期语言模型基准测试的到来:在同一个实验里,它既显示了分类信号,也暴露了数值预测的失败。
这里没有 2023 年预印本
实验在2023年11月至12月进行,公开代码仓库在12月30日留下了首个提交。这两件事都不是发表日期。
arXiv 官方版本记录只列出一个版本 2401.01620v1,提交时间为2024年1月3日 08:41:27 UTC。记录中没有2023年的公开版本,也没有后来的 v2。期刊论文于3月8日接受,6月5日在线发表,并编入2024年8月刊。
这一区分很重要,因为模型、实验、代码、预印本和期刊论文各有自己的时间轴。把它们压缩成“一篇2023年预印本和一篇2024年论文”,故事是干净了,代价却是一个错误的日期。历史定位是2024年1月3日,即这项基准测试首次公开的日子。
模型读到的不是整份电子病历
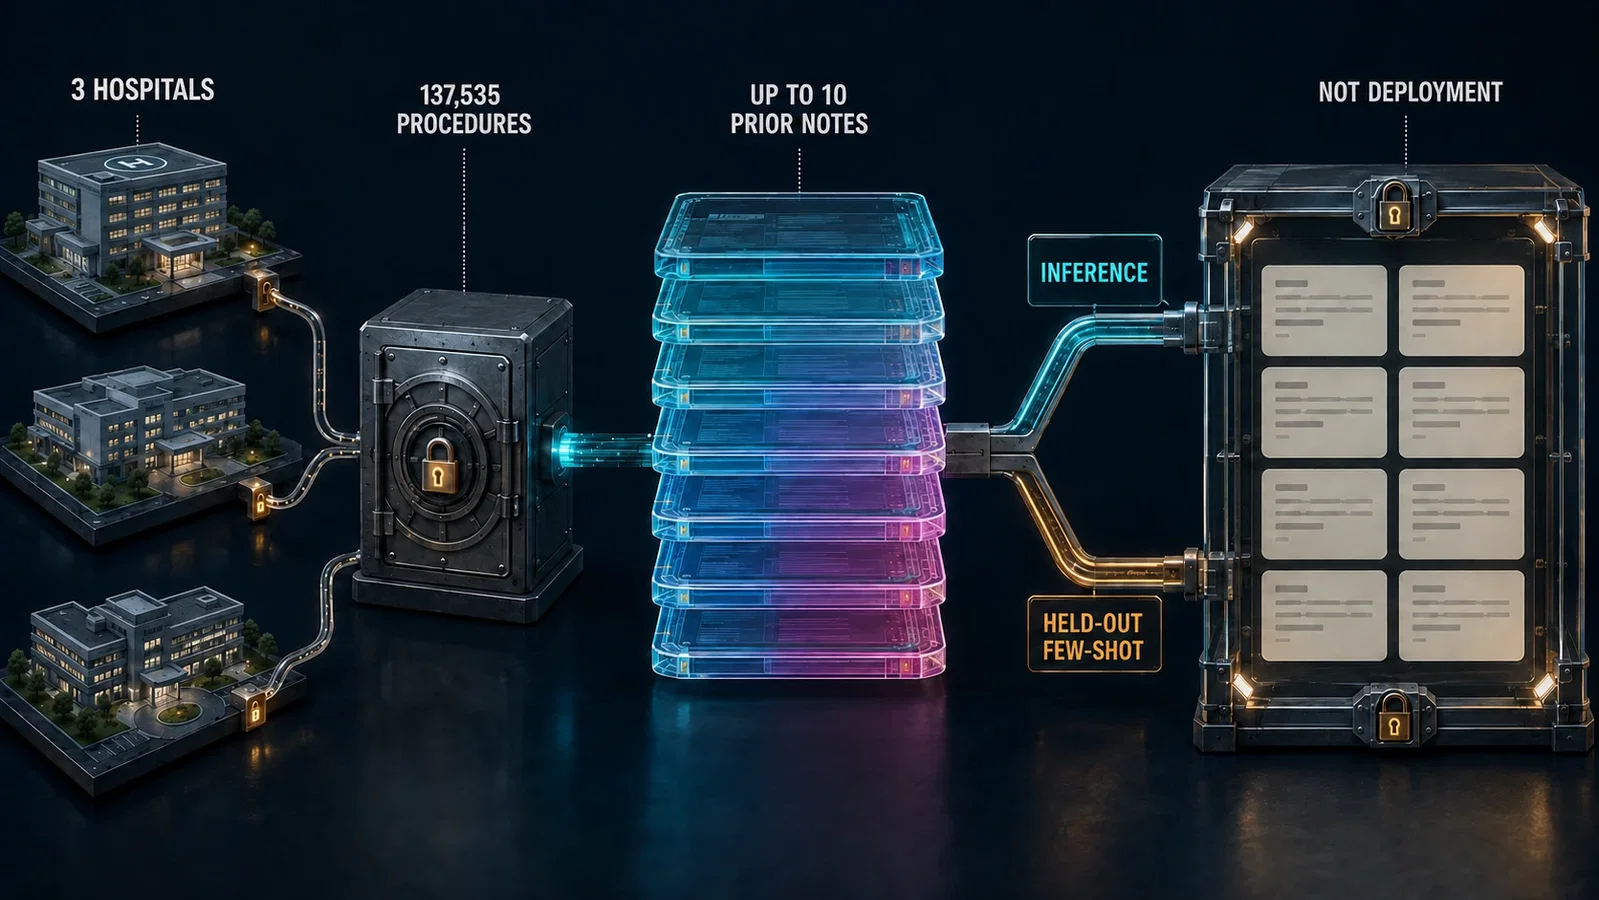
原始资料来自西雅图三家华盛顿大学医院:UW Medical Center-Montlake、UW Medical Center-Northwest 和 Harborview Medical Center。从2021年4月1日至2023年5月5日,原始队列包括90,844名患者、137,535台在麻醉管理下进行的手术或操作。
每个纳入病例都有一份麻醉术前评估,以及术前至少一份其他临床记录。然而,麻醉术前评估本身被排除在实验输入之外。
GPT-4 Turbo 读取的是手术或操作名称、操作描述、诊断、手术科室,以及最多十份最近的、由其他临床人员书写的记录。少于100个 token 的记录被剔除,因为其中许多只是行政说明或签署证明,几乎没有临床内容。典型病例保留下来的记录约为四份,而不是十份。
因此,这不是一个让模型在整份病历中自由浏览的实验,也不是让模型抄写麻醉医师已完成的术前风险评估的捷径。问题更窄,也更有意思:通用模型能否从一组有限的临床叙事与预约字段中,抽取有用的围术期信号?
研究者没有针对这些患者微调一个新模型。他们在2023年11月至12月通过 Microsoft Azure OpenAI Service 调用 GPT-4 Turbo,编写提示词,并要求输出结构化 JSON 答案和一段解释。新意在于,通过提示词把一个现成的通用模型引向若干临床预测任务。
七个数据集回答八个问题
研究者为八项结局建立了七个任务专用数据集,因为 ICU 入院和 ICU 停留时长使用同一批病例。在每项任务内部,同一患者只保留一个病例。病例足够时,研究者抽取1,250例,分成1,000个推理病例和一个独立的250例病例库,后者用于构建少样本示例。
罕见结局无法达到这个目标数。非计划住院任务有949个推理病例和237个少样本病例;死亡任务分别为576个和144个。
各任务的数据集之间也有重叠。不能把它们相加成7,525名独立评估的患者。同一位患者可以进入不止一个任务专用数据集,尽管在任何单一任务中,这位患者只保留了一台手术。
抽样对核心结果含义的改变,比重叠更大。
在全部137,535台原始手术中,术后 ICU 入院率为0.49%,非计划住院率为0.43%,院内死亡率为0.3%。在相应的专用预测数据集中,研究者把这些结局抽样到阳性与阴性两组大致相等。ASA 分级和时长区间也通过逆频率抽样重新平衡。
这一选择让不同提示策略更容易比较。没有它,模型只要预测占绝大多数的阴性类别,就能显得出奇地好。但平衡后的实验无法告诉一家医院:当结局患病率回到千分之三或千分之五时,会出现多少误报。
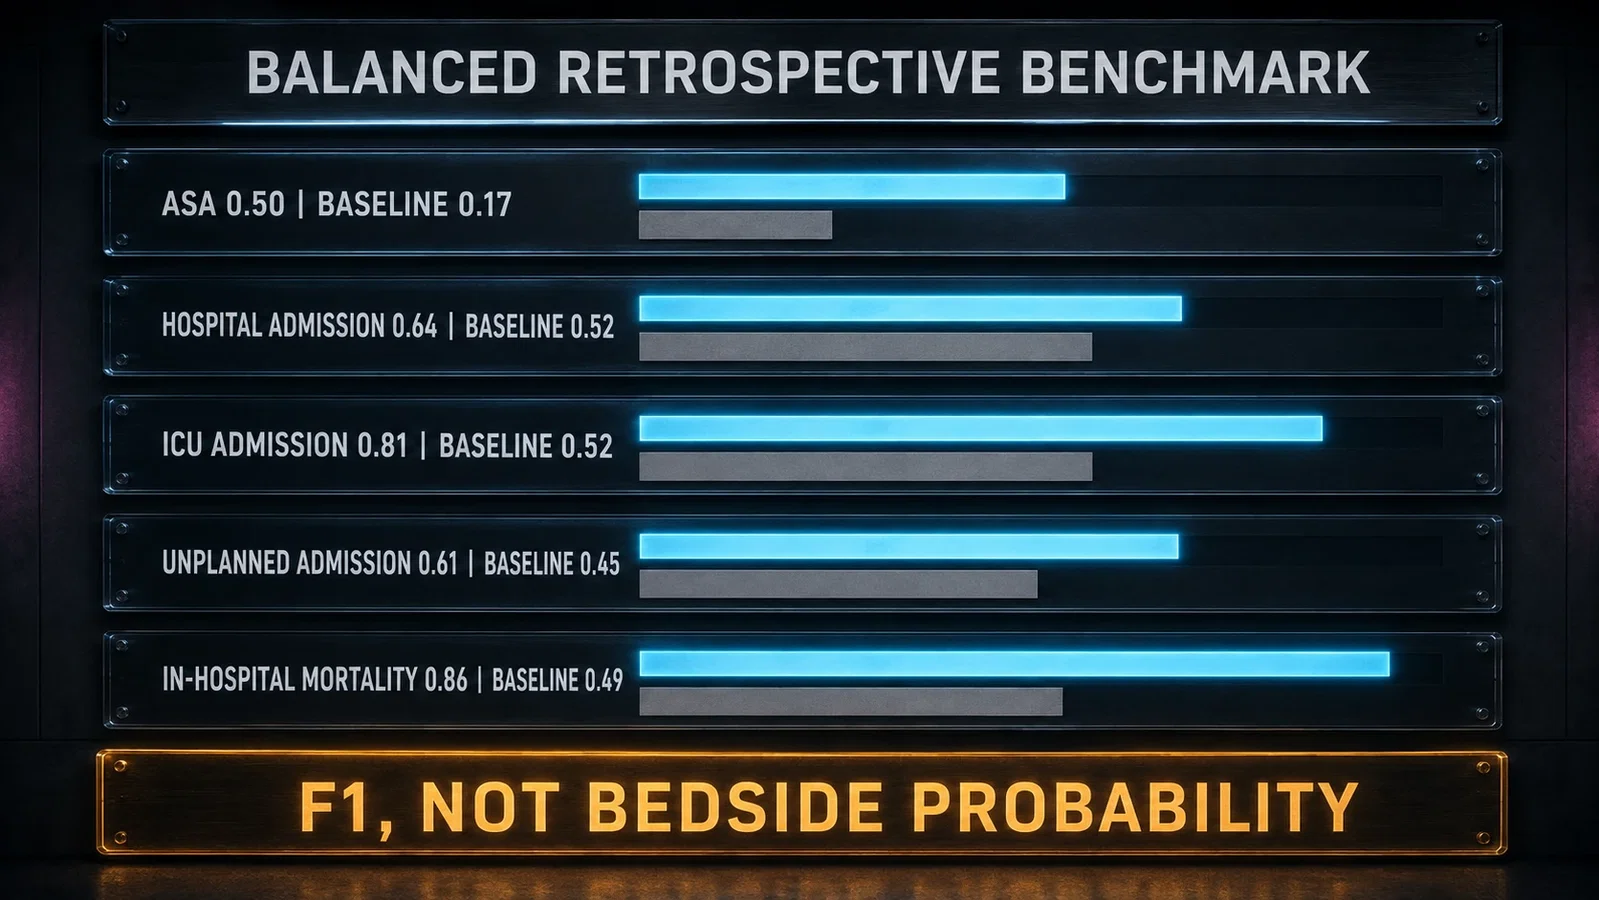
在阳性率接近50%的样本上得到的 F1 分数,不是床旁概率。它不能确立原始患病率下的校准度、阳性预测值或运行负担。
分类任务包含真实的信号
五项分类任务中,二分类结局用 F1 评分,六级 ASA 身体状况分级用 F1-micro 评分。每个结果都与一个随机分类器比较,而不是与临床医师或经过验证的围术期风险模型比较。
各任务的最佳结果如下:
- ASA 身体状况分级:F1-micro 0.50,95% 置信区间 0.47 至 0.53;随机基线 0.17。
- 术后住院:F1 0.64,95% 置信区间 0.61 至 0.67;基线 0.52。
- ICU 入院:F1 0.81,95% 置信区间 0.78 至 0.83;基线 0.52。
- 非计划住院:F1 0.61,95% 置信区间 0.58 至 0.64;基线 0.45。
- 术后院内死亡:F1 0.86,95% 置信区间 0.83 至 0.89;基线 0.49。
ICU 入院和死亡的结果引人注目。它们表明,手术信息和临床叙事中包含某种结构,通用语言模型无需在这一队列上训练新的任务专用模型,就能加以利用。
它们并没有显示“86%的准确率”。F1 是精确率与召回率的调和平均数,不是全部预测中正确的比例。而且,尽管死亡只发生在0.3%的原始手术之后,死亡任务却是用一个大致平衡的样本构建的。
ASA 结果尤其能体现“能力”的双重含义。从六级随机基线0.17提高到0.50并非小事。然而0.50仍意味着大量误分类,错误常发生在相邻的 ASA 等级之间。住院和非计划住院的提升则更为温和。
站得住脚的结论是精确的:在若干内部构建、经过平衡的分类数据集上,GPT-4 Turbo 优于随机的任务专用基线。这并不是对真实世界预测准确性的证明。
时长预测让流畅文字失去了掩护
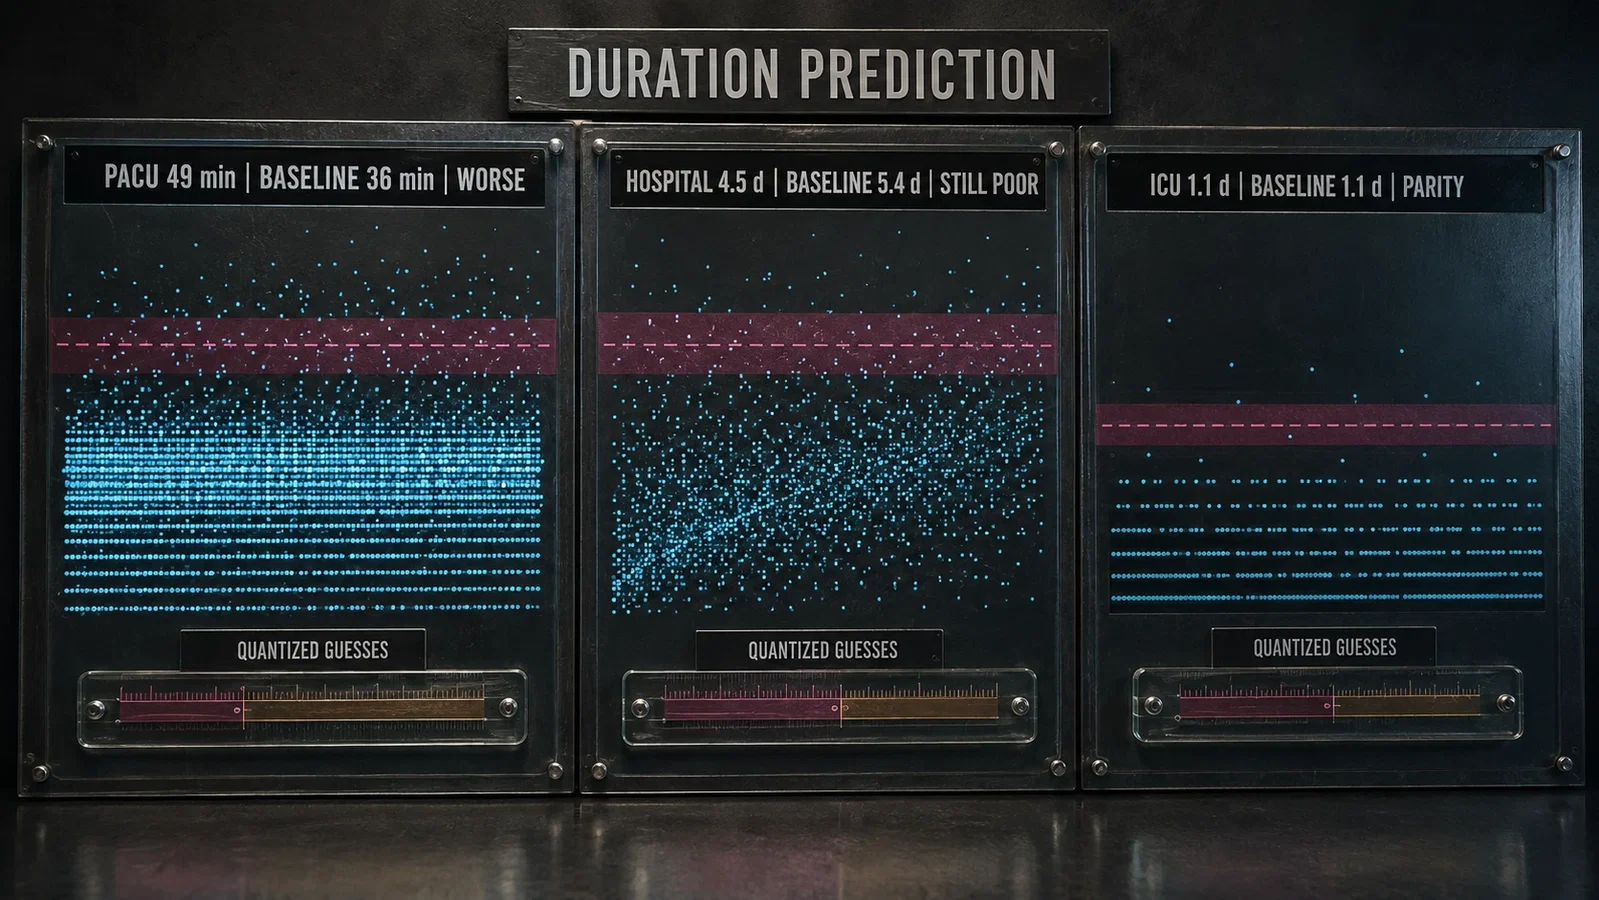
另外三项任务要求给出连续数值。表现用平均绝对误差衡量,并与一个永远返回数据集均值的虚拟回归器比较。
对于 PACU 第一阶段时长,模型的最佳误差为49分钟,95% 置信区间46至51分钟。均值基线的误差只有36分钟。语言模型反而更差。
对于住院时长,最佳模型误差为4.5天,基线为5.4天。这是适度的数值改善,不能证明个体层面的预测在临床上已经足够。
对于 ICU 时长,模型和基线的误差都在1.1天左右。
补充材料中的散点图比汇总指标更能说明这一弱点。预测值聚集成一条条水平带,停在熟悉的整数上。某些策略还显出明显的上限。真实停留时间沿横轴一路延伸,模型却一再回到少数几个看似合理的时长。
语言模型极其擅长给出一个听起来像合理住院天数的数字。这并不意味着它学会了患者病历与时间之间稳定的连续映射。同一架构能区分某些二分类结局,却常常把时长当作一组常见的口头猜测。
分类能力与时长失败,并不是对这篇论文相互竞争的两种解读。二者合在一起,才是它最经得起时间检验的结果。
提示词更像实验变量,而不是神奇的剂量
研究交叉比较了几种提示选择:原始记录与 GPT-4 Turbo 生成的摘要、零样本与少样本提示,以及有无链式思考指令的回答。少样本条件分别使用5、10、20或50个示例。
示例来自独立的20%少样本病例库,而不是来自被评分的推理病例。对于链式思考示例,GPT-4 Turbo 先得到正确标签,再生成一段推理。非链式提示要求先给答案、后给解释;链式提示则颠倒顺序,要求先逐步推理、再给答案。
没有出现单调的规律。
链式思考改善了一些分类设置,却并未惠及所有任务。摘要可能让上下文更聚焦,也可能删掉有用的细节。增加示例数量对某些组合有帮助,对另一些则更差,尤其是在数值结局中。
五十个示例并不自动优于五个。要求更多推理,并不能可靠地让答案更准确。提示设计仍是一项需要检验的干预,而不是放之四海而皆准的处方。
有一个病例值得作为脚注。在非计划住院数据集中,某位患者唯一保留的记录不含任何临床相关内容。GPT-4 Turbo 在全部五次允许的尝试中都拒绝预测。这提示模型有时能识别上下文不足。但这只是一个病例,不是一项关于拒答、安全性或校准不确定性的设计研究。
解释是生成出来的,不是验证过的
每个预测都附有一段自然语言解释。这些文字能把诊断、病史和手术与答案联系起来,方式让临床医师感到熟悉。
1月的预印本突出了这一特性。它用相当积极的措辞描述这些解释,并较快地从基准表现转向可能的临床辅助。
同行评议论文加上了一条关键限制:解释质量没有金标准。专家没有系统评估这些解释是否忠实、完整、带有偏见、具有误导性或在临床上有用。研究也没有检验阅读这些解释能否改善临床医师的决策。
可读性是一种界面特性,不是理由正确的证据。
实验也没有与麻醉医师、其他临床人员、成熟的风险计算工具或专用的围术期机器学习模型进行直接比较。讨论部分提到,既往研究中的专用表格模型在严格 F1 指标上可能表现更强。这是一种背景性的观察,不是本研究所做的比较。
在这项研究中,“GPT-4 胜过医生”或“胜过传统风险模型”之类的说法,没有任何实验分母。
六千美元买到的是一次实验,不是一套临床系统
官方工作簿记录,八项任务的 Azure GPT-4 Turbo API 调用合计约6,002.01美元,包括输入和输出 token。它有助于衡量2023年末反复进行长上下文实验的代价。
它不是当前的云服务报价。它不包括临床工具周围那套大得多的系统:数据治理、系统集成、安全、监测、人工复核、漂移检测、实施和问责。
研究者公开了用于数据处理、提示词构造、输出校验、重试处理、指标计算和分析的代码。存档的公开代码仓库让方法的重要部分可以被检查。
其中不含患者数据。官方数据共享声明指出,原始数据集和生成的数据集不能公开发布,因为它们来自含有受保护健康信息的电子病历。可以依据华盛顿大学的数据使用协议和机构政策申请获取。
因此,公开代码提高了透明度,却不能让这个队列被完整复现。它也不能证明,另一个卫生系统在病历、记录习惯、患病率、基础设施或模型服务状态不同的情况下,能够重现这些结果。
同行评议为核心结论补上了条件
论文的数值核心从1月的预印本一直保留到6月的正式发表。最终报告通过明确写出缺失的证据,改变了结论的分量。
同行评议版本的局限性部分涉及:真实患病率下的评估、长上下文的成本、单一系统的可推广性、解释缺乏金标准、临床判断中可能的偏见、与专用模型的比较,以及前瞻性验证的必要。
这不是从实验后退。它把实验放回了证据阶梯上正确的那一级。
回顾性的内部表现是第一级。外部验证、前瞻性工作流评估、人与模型的互动、自然患病率下的校准、监管评估和患者结局都在后面。流畅的文字不能用来跳过中间的台阶。
进入围术期医学的,是一组新问题
这项研究没有表明 GPT-4 Turbo 能决定谁该进入 ICU。它没有证明分诊更好、并发症更少或生存率提高。它也没有评估或支持自主行动。
它确立了一件更基础、也更可能持久的事:围术期临床叙事已经成为通用语言模型可以测量的输入。单个经提示的模型能在若干任务中抽取分类信号,而无需为每项任务单独开展专门的训练。
与此同时,平衡抽样、相互重叠的数据集、好坏参半的提示效果、未经验证的解释和糟糕的时长预测,使这个信号无法成为床旁结论。
2024年1月3日出现在时间线上,并不是因为机器在那天承担起了围术期风险评估的责任。
它之所以在那里,是因为这一领域得到了一次足够完整的展示,看到了这项技术的两面。临床语言中包含信号。流畅的输出并没有免除验证的必要。
分类任务让能力显形。
时长预测让边界显形。
二者都是这段历史的一部分。
来源与阅读范围
公开日期为2024年1月3日。
来源:Chung P, Fong CT, Walters AM, Aghaeepour N, Yetisgen M, O'Reilly-Shah VN. JAMA Surg. 2024;159(8):928-937. PMID 38837145. PMCID PMC11154375. DOI 10.1001/jamasurg.2024.1621;JAMA Surgery 官方电子补充材料 1-3;arXiv:2401.01620v1,2024年1月3日提交;PubMed、Crossref、PMC、arXiv 和 GitHub 记录的存档;公开代码存档于提交 5a3beeb3ca6c5ff4fbe9c222aef6d05834417a58。本文讲述的是一项回顾性内部基准测试的历史,不是个体化医疗建议,也不是已部署的决策支持系统。
视觉诠释
这些插图探索当时的情境与观念。图中的人物、动作、器械和文件均为重构,并不证明它们确切的历史样貌。
继续阅读
相关阅读只表示问题和背景相关,本身不证明历史上的影响关系。
相关阅读
- 2008年:STOP-Bang 让 OSA 风险在进入手术室前被看见
- 2010年:Makary的五项研究把衰弱带进术前评估
- 2018年:FDA让HPI预测未来,却不让它独自决定治疗
- 2019年:ENGAGES让麻醉暴露降了,谵妄却没有少
- 2020年:COVIDSurg——1128名患者把第一波手术风险变成国际警报
- 2023年:FDA 为 NOL 指数建立新器械类型
Anesthesia Epochs · The Source Room · About & Editorial Method
中文版与英文原文一一对应;如有出入,以英文版为准。来源与阅读范围见上文。插图均标明为原始资料图片或 AI 制作。历史叙述仅供教育,不是当前的治疗建议。