2010年,一个由594名接受择期手术的老年患者组成的队列,让握力、步速和生理储备在传统风险评分之外变得可见。
中文阅读 · 英文原文:2010: Makary's Five-Item Study Brings Frailty into Preoperative Assessment
观看配套影片
2010: Makary — Frailty and Surgical Outcomes · 在 YouTube 观看
(视频托管在 YouTube,中国大陆可能无法访问。)
历史定位:2010年。日期细节与来源限定见正文。
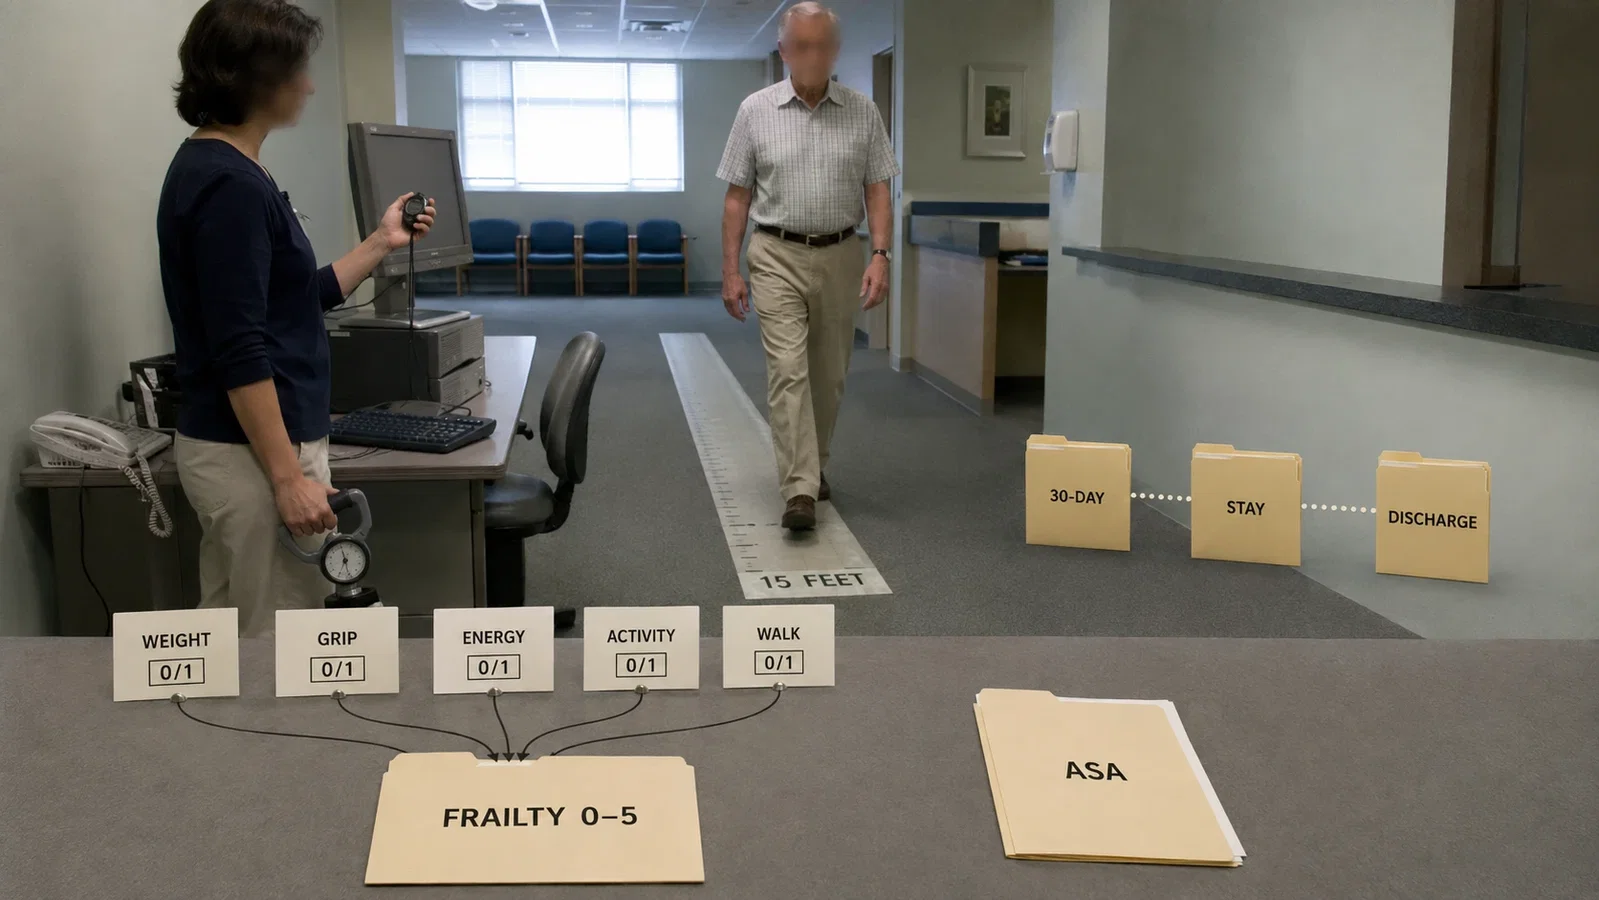
这项研究里最能说明问题的仪器,并不是一台新的监护仪,而是一只握力计。
在一次术前就诊中,一位老年患者用优势手把它握了三次。一名研究助理还询问了体重下降、疲惫和近期活动情况,然后给一段15英尺的步行计时。五项普通的观察,每项记0或1分,被组合成对一件临床医生长期凭印象判断之事的估计:手术施加应激时,一位患者可能还剩多少储备。
2010年4月28日,Martin Makary及其同事在线发表研究结果时,并没有声称发明了衰弱。Linda Fried及其同事早已在社区居住的老年人中,把一个五要素的表型变成可操作的定义。这项外科研究问的是另一个问题:在美国麻醉医师协会(ASA)身体状况分级以及Lee和Eagle心脏风险指数等熟悉的指标之外,这一表型能否在手术前提供有用的信息?
评估用五项任务取代了一种印象
五个领域彼此相关,但测量的并不是同一件事。
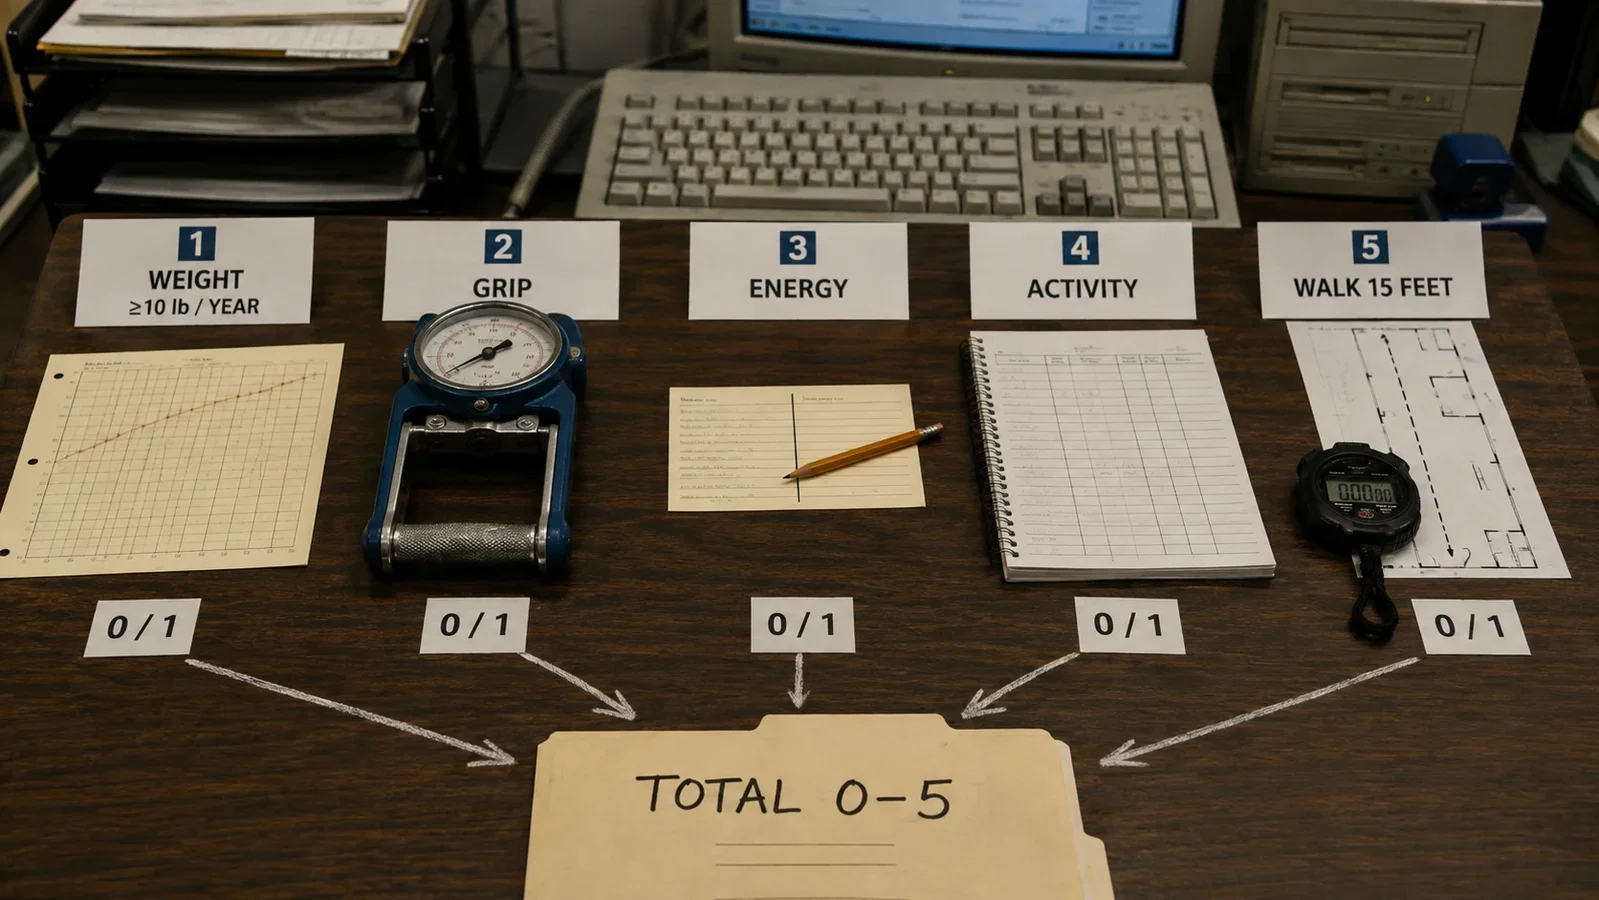
“消瘦”指前一年非意愿性体重下降至少10磅。“虚弱”用手持握力计测量:三次最大握力取平均,再按性别和体重指数(BMI)的阈值判断。“疲惫”来自两个关于费力和提不起劲的简短问题。“低活动量”依据前两周报告的休闲活动。“缓慢”是按平常速度走15英尺、三次的平均值,再按性别和身高判断。
每个领域计1分,合计0到5分。之所以要组合,是因为衰弱在这里并不是年龄、残疾或病历中诊断数目的同义词。一位老人不必看上去有病、坐轮椅,或符合某种视觉刻板印象,就可能符合一项或多项标准。这项评估用记录下来的测量取代了那种印象。
作者报告,在一个繁忙的外科门诊里,整套评估约需10分钟。这是在该环境中的可行性观察,并不能证明每家门诊都能以同样的人员、时间或成本实施。
分母从666开始,而不是594
这是一项前瞻性观察研究,2005年6月22日至2006年7月1日在约翰斯·霍普金斯医院麻醉术前评估中心进行。患者年龄65岁及以上,准备接受择期手术。
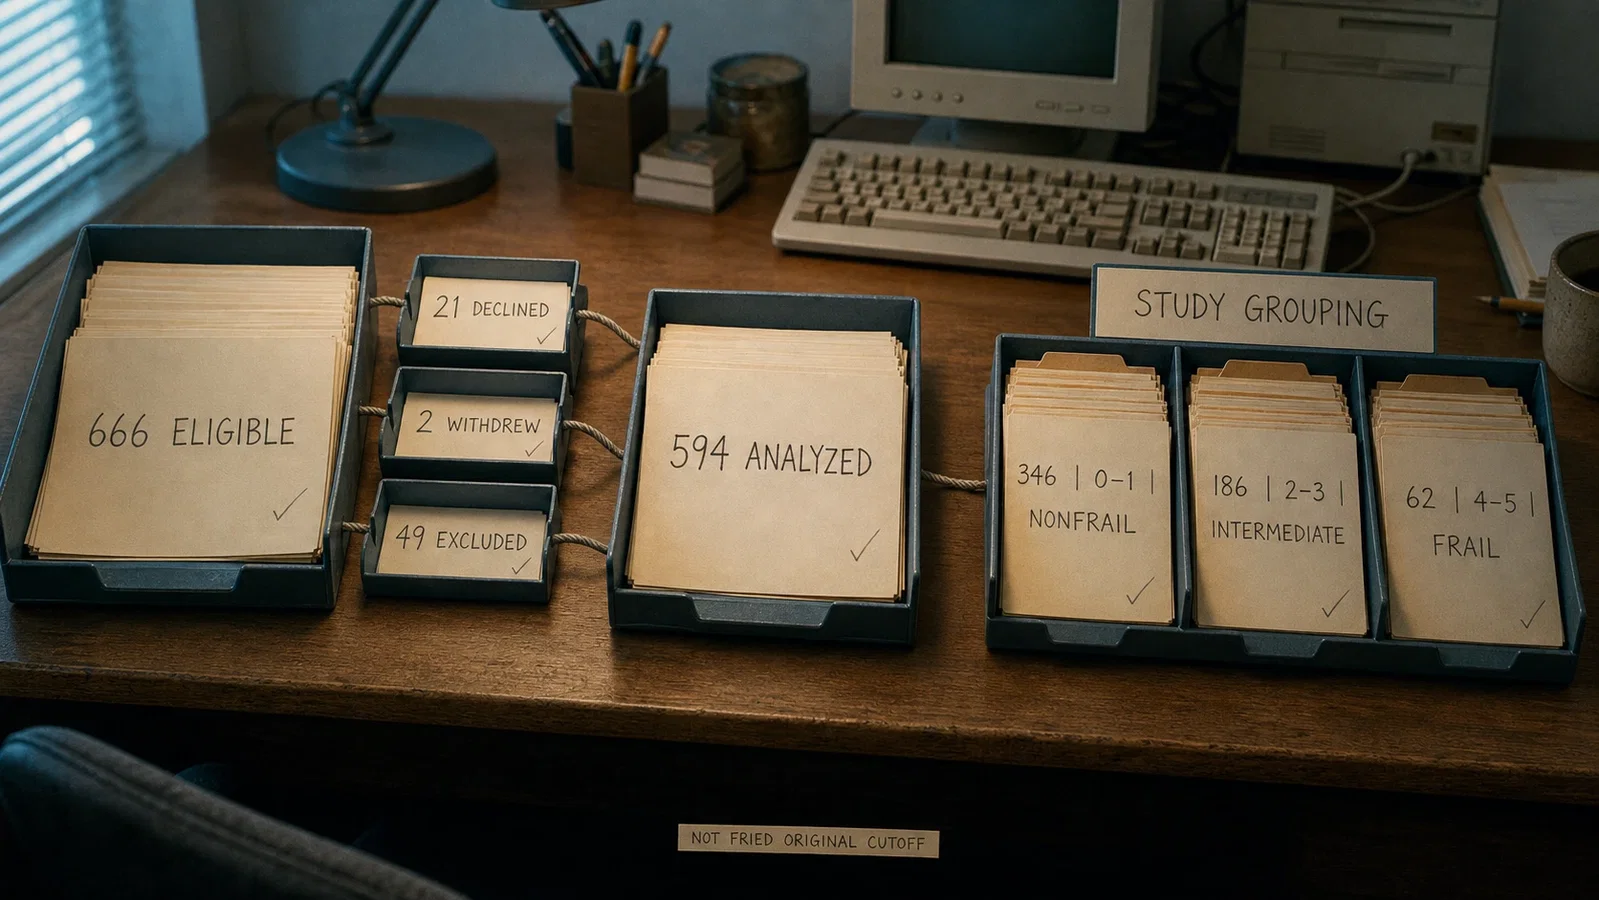
招募并没有覆盖每一天的每一位患者。团队在选定的工作日抽样,并定期轮换这些日子。在抽样日里,有666名患者符合条件。21人拒绝参加,2人后来退出。另有49人因研究规定的神经、认知或用药标准被排除:2人患帕金森病,11人既往有卒中,2人简易精神状态检查(MMSE)得分低于18分,34人正在服用效果可能与表型组成部分重叠的特定药物。最终队列为594人。
访谈和衰弱评估由一名研究助理完成。负责分析的作者没有参与数据收集。一名麻醉医生在不知道衰弱评分的情况下独立给出ASA分级,临床医护人员也不知道衰弱结果。
这些分隔加强了衰弱与已有风险信息之间的比较,也界定了这项研究无法检验的东西。一个从未看到评分的团队,不可能因为评分而改变照护;因此这项研究并没有追问:告知衰弱状况、修改麻醉方案、增加老年医学共管或开始术前预康复,是否会改善结局。
外科研究改变了分类边界
五个领域来自一个已确立的表型,但外科论文所用的三个类别标签,并不是原封不动地从Fried的原始报告中搬来的。
Makary及其同事先在自己的外科数据中考察0至5分与事件之间的关系。他们的探索性分析发现,在三个分段之内事件的比值相近,于是把0或1项标准归为“非衰弱”,2或3项归为“中度衰弱”,4或5项归为“衰弱”。
这个区别在后来的概述中很容易丢失。2001年Fried的摘要把1或2项标准定义为中间状态,3项及以上定义为衰弱。Makary的0–1 / 2–3 / 4–5分段,是在考察这一外科队列之后得出的研究特有分组。它们也与后来的Rockwood临床衰弱量表(Clinical Frailty Scale)以及累积缺陷的改良衰弱指数无关。如果不说明所用的工具,“4分”就没有稳定的含义。
在594名参与者中,346人归为非衰弱,186人为中度衰弱,62人为衰弱。这些比例——58.3%、31.3%和10.4%——描述的是这个经过选择的单中心择期手术队列,不是所有老年手术患者的一般患病率估计。
三个结局把储备与术后事件并列
主要结局是:按美国外科医师学会国家外科质量改进计划(NSQIP)标准定义的30天内手术并发症;住院时间;以及术前住在家中的患者出院后转往专业护理机构或协助生活机构。
在纳入全部指定调整因素的强制模型中,与非衰弱组相比,中度衰弱组发生并发症的比值比为2.06,95%置信区间为1.18至3.60;衰弱组的比值比为2.54,置信区间为1.12至5.77。
住院时间用负二项模型分析。相应的发生率比为1.49(95%置信区间1.24至1.80)和1.69(置信区间1.28至2.23)。这些比值描述的是模型中预期住院时间的相对差异,并不意味着患者多住了1.49天或1.69天。
出院去向的关联更大,也更不精确。在术前住在家中的患者里,中度衰弱组转往专业护理机构或协助生活机构的比值比为3.16,置信区间为1.00至9.99;衰弱组为20.48,但区间从5.54一直延伸到75.68。只报告点估计而不报告这个宽阔的区间,会把不确定性变成虚假的视觉确定性。
这些都是调整后的关联。队列中的患者并没有被随机分配到某种衰弱状态、某种筛查策略或某种治疗。“预防”“导致”或“挽救”之类的词,描述的将是一项并未进行的研究。
衰弱给传统评分增加了什么?
论文的第二项贡献,并不只是各组结局不同。它检验了这一表型能否给三个熟悉的风险指数增加区分能力。
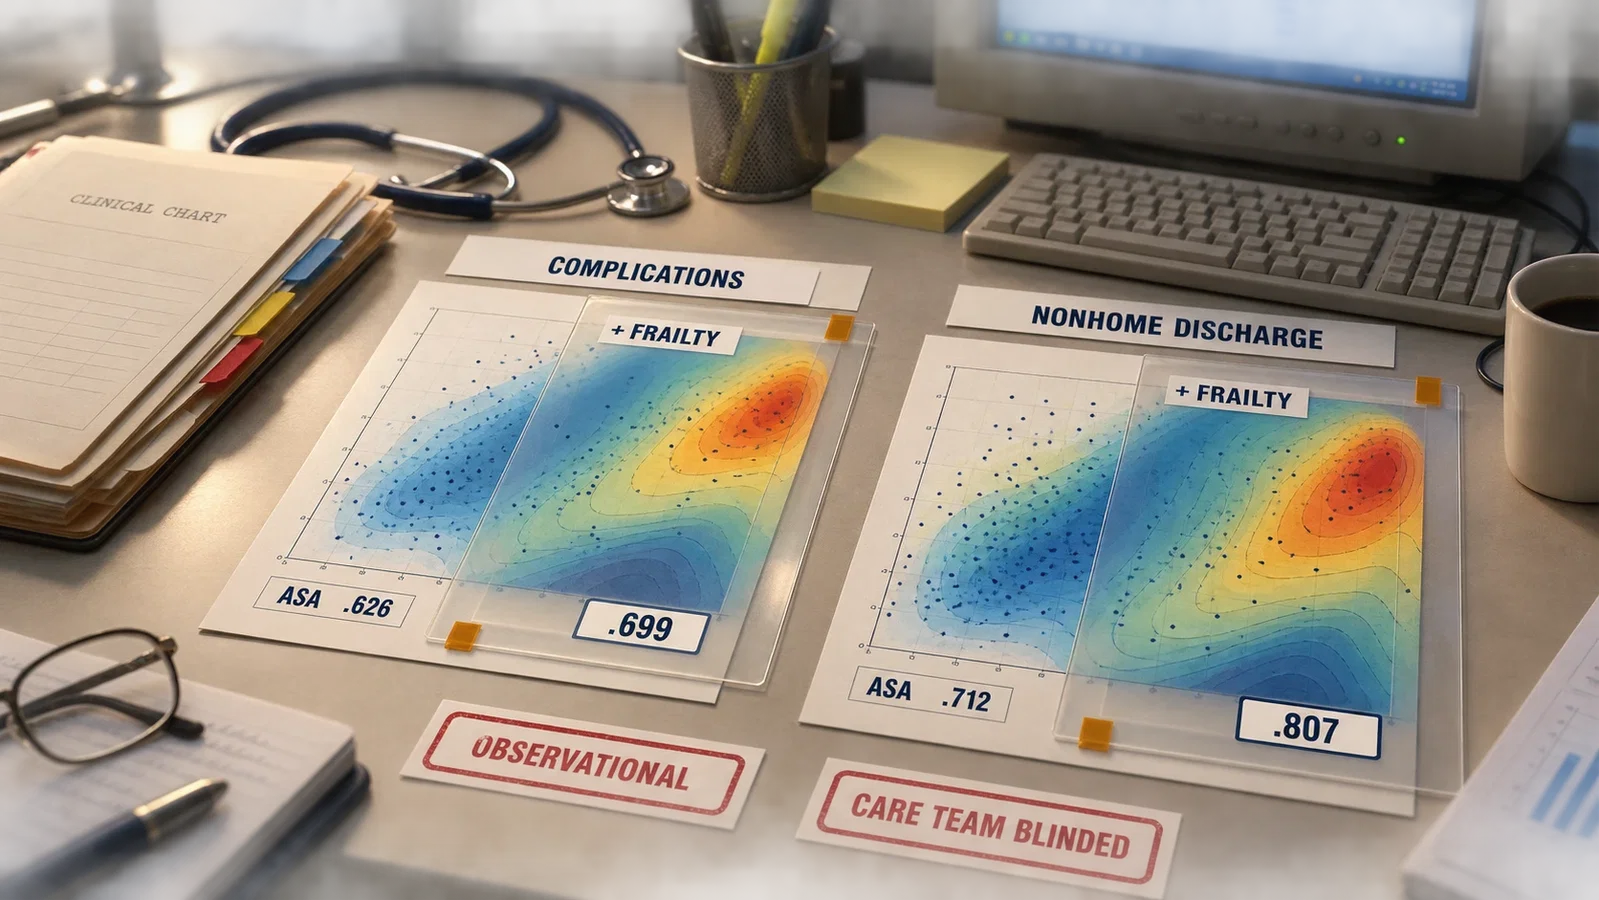
最清楚的比较是交叉验证分析。对于手术并发症,加入衰弱后,曲线下面积(AUC)在ASA从0.626增至0.699,在Lee从0.618增至0.669,在Eagle从0.678增至0.714。对于转往专业护理机构或协助生活机构,相应的变化是0.712至0.807、0.669至0.795和0.661至0.759。
表中还有基于原始数据集的各行,其估计值和p值不同。关于并发症的两项原始数据集比较没有达到常规的显著性阈值,尽管交叉验证的各行达到了。这一点很重要,因为摘要中“衰弱使每个指数都得到改善,p < .01”的简洁说法,不应套用到表中的每一格。
AUC增加意味着加入新信息后,模型对各组的区分略好一些。它并不意味着某个评分预言了某一个人的康复,也不意味着更准确的分类会自动带来更好的照护。
采用先于干预的证明
作者把他们的工作称为已知第一项关于术前衰弱与手术结局的研究。这是他们自己的首创主张,不是一次独立的全球检索的结果。2012年的指南显示了这一指标进入实践指导的速度之快。
2012年,美国外科医师学会NSQIP与美国老年医学会(American Geriatrics Society)联合发布的老年手术患者最佳实践指南,把“确定基线衰弱评分”列入术前评估清单。其衰弱一节概述了外科研究中的关联,附录III经许可重印了这套五项评分。论文发表后两年之内,这一表型已经从一份研究方案进入一个专业评估框架。
被指南采纳并没有抹去原有的局限。研究测量的是短期结局,而不是长期功能或生活质量。它没有纳入血细胞计数或白蛋白等可能有用的实验室变量。它来自一家学术医学中心,其抽样和排除限制了可推广性。最重要的是,医护人员对评分不知情,因此这项研究无法揭示知道评分会带来什么影响。
因此,2010年的论文标志的是术前可以讨论的内容发生了变化,而不是一条治疗路径的完成。体重变化史、握力、精力、活动量和步速,为临床医生提供了一种可重复的方式,来描述年龄和疾病清单无法完全反映的储备。依据这些信息采取行动是否会改变康复,仍是留给后来试验的问题。
握力计并没有预言患者的命运。它让患者起始状况中的一部分更难被忽视。
来源与阅读范围
来源:Makary MA, Segev DL, Pronovost PJ, et al. J Am Coll Surg. 2010;210(6):901–908. DOI 10.1016/j.jamcollsurg.2010.01.028; Fried LP, Tangen CM, Walston J, et al. J Gerontol A Biol Sci Med Sci. 2001;56(3):M146–M156. PMID 11253156; ACS NSQIP/AGS Best Practices Guidelines: Optimal Preoperative Assessment of the Geriatric Surgical Patient. 2012。Makary论文全文已完整阅读,全部8页均经目视查看;指南的相关章节和附录已阅读。Fried 2001仅在官方摘要层面使用。
视觉诠释
这些插图探索的是场景与观念。画面中的人物、动作、器具和文件均为重构,不能作为它们确切历史面貌的证据。
中文版与英文原文一一对应;如有出入,以英文版为准。来源与阅读范围见上文。插图均标明为原始资料图片或 AI 制作。历史叙述仅供教育,不是当前的治疗建议。
继续阅读
相关阅读只表示问题和背景相关,本身不证明历史上的影响关系。
- 1941年:Saklad的身体状况分级为患者记录提供共同语言
- 2001年:Fried衰弱表型让一个临床概念变得可以测量
- 2005年:Rockwood临床衰弱量表检验一种临床判断
- 2015年:老年外科患者的照护成为一条围术期路径
- 2022年:POISE-3 发现氨甲环酸减少出血,但未证实心血管非劣效
- 2024年:GPT-4 Turbo 能为术前文本分类,却难以预测时长
- 2024年:九个组织把术前心脏“许可”变成一条连续路径
Anesthesia Epochs · The Source Room · About & Editorial Method